Trong phần này, chúng ta sẽ tìm hiểu cách dùng pipeline() để tận dụng các model được huấn luyện sẵn (pre-trained) cho nhận dạng giọng nói. Ở Unit 2, chúng ta đã giới thiệu pipeline() như một cách dễ dàng để chạy tác vụ nhận dạng giọng nói: mọi bước tiền xử lý và hậu xử lý đều được lo sẵn bên dưới, và bạn có thể nhanh chóng thử nghiệm với bất kỳ checkpoint huấn luyện sẵn nào trên Hugging Face Hub. Trong bài này, chúng ta sẽ đi sâu thêm một bậc, khám phá các đặc tính khác nhau của model nhận dạng giọng nói và cách dùng chúng để giải quyết nhiều tác vụ khác nhau.
Như đã trình bày ở Unit 3, model nhận dạng giọng nói nhìn chung thuộc một trong hai nhóm:
- Connectionist Temporal Classification (CTC): model chỉ có encoder (encoder-only) với một đầu phân loại tuyến tính (CTC) ở trên
- Sequence-to-sequence (Seq2Seq): model encoder-decoder, có cơ chế cross-attention giữa encoder và decoder
Trước năm 2022, CTC là kiến trúc phổ biến hơn trong hai loại, với các model chỉ có encoder như Wav2Vec2, HuBERT và XLSR tạo ra những đột phá trong mô hình pre-training / fine-tuning cho giọng nói. Các tập đoàn lớn như Meta và Microsoft đã pre-train encoder trên lượng lớn dữ liệu âm thanh chưa gán nhãn trong nhiều ngày hoặc nhiều tuần. Sau đó, người dùng có thể lấy một checkpoint huấn luyện sẵn và fine-tuning nó với một đầu CTC trên chỉ khoảng 10 phút dữ liệu giọng nói có gán nhãn để đạt hiệu năng tốt trên một tác vụ nhận dạng giọng nói cụ thể.
Tuy nhiên, model CTC có những hạn chế. Gắn một lớp tuyến tính đơn giản lên encoder cho ra một model tổng thể nhỏ và nhanh, nhưng dễ mắc lỗi chính tả theo âm. Chúng ta sẽ minh hoạ điều này với model Wav2Vec2 dưới đây.
Khảo sát model CTC
Hãy tải một đoạn nhỏ của bộ dữ liệu LibriSpeech ASR để minh hoạ khả năng chép lời của Wav2Vec2:
from datasets import load_dataset

dataset = load_dataset(
    "hf-internal-testing/librispeech_asr_dummy", "clean", split="validation"
)
dataset
Output:
Dataset({
    features: ['file', 'audio', 'text', 'speaker_id', 'chapter_id', 'id'],
    num_rows: 73
})
Chúng ta có thể chọn một trong 73 mẫu âm thanh và xem cả mẫu âm thanh lẫn bản chép lời:
from IPython.display import Audio

sample = dataset[2]

print(sample["text"])
Audio(sample["audio"]["array"], rate=sample["audio"]["sampling_rate"])
Output:
HE TELLS US THAT AT THIS FESTIVE SEASON OF THE YEAR WITH CHRISTMAS AND ROAST BEEF LOOMING BEFORE US SIMILES DRAWN FROM EATING AND ITS RESULTS OCCUR MOST READILY TO THE MIND
Được rồi! Giáng sinh và thịt bò nướng, nghe thật tuyệt! Sau khi chọn được mẫu dữ liệu, giờ chúng ta tải một checkpoint đã fine-tuning vào pipeline(). Ở đây, chúng ta dùng checkpoint chính thức Wav2Vec2 base đã fine-tuning trên 100 giờ dữ liệu LibriSpeech:
from transformers import pipeline

pipe = pipeline("automatic-speech-recognition", model="facebook/wav2vec2-base-100h")
Tiếp theo, chúng ta lấy một mẫu từ bộ dữ liệu và đưa dữ liệu thô của nó vào pipeline. Vì pipeline tiêu thụ mọi dictionary mà chúng ta truyền vào (nghĩa là không dùng lại được), chúng ta sẽ truyền một bản sao của dữ liệu. Nhờ vậy, chúng ta có thể dùng lại cùng mẫu âm thanh đó một cách an toàn trong các ví dụ tiếp theo:
pipe(sample["audio"].copy())
Output:
{"text": "HE TELLS US THAT AT THIS FESTIVE SEASON OF THE YEAR WITH CHRISTMAUS AND ROSE BEEF LOOMING BEFORE US SIMALYIS DRAWN FROM EATING AND ITS RESULTS OCCUR MOST READILY TO THE MIND"}
Có thể thấy model Wav2Vec2 chép lời mẫu này khá tốt: thoạt nhìn thì nhìn chung là đúng. Hãy đặt văn bản đích và dự đoán cạnh nhau rồi đánh dấu chỗ khác biệt:
Target:      HE TELLS US THAT AT THIS FESTIVE SEASON OF THE YEAR WITH CHRISTMAS AND ROAST BEEF LOOMING BEFORE US SIMILES DRAWN FROM EATING AND ITS RESULTS OCCUR MOST READILY TO THE MIND
Prediction:  HE TELLS US THAT AT THIS FESTIVE SEASON OF THE YEAR WITH **CHRISTMAUS** AND **ROSE** BEEF LOOMING BEFORE US **SIMALYIS** DRAWN FROM EATING AND ITS RESULTS OCCUR MOST READILY TO THE MIND
So sánh văn bản đích với bản chép lời dự đoán, chúng ta thấy mọi từ đều nghe đúng, nhưng một số từ bị viết sai chính tả. Ví dụ:
- CHRISTMAUS so với CHRISTMAS
- ROSE so với ROAST
- SIMALYIS so với SIMILES
Điều này cho thấy hạn chế của model CTC. Về bản chất, model CTC là model "chỉ dựa trên âm học" (acoustic-only): nó gồm một encoder tạo biểu diễn trạng thái ẩn (hidden-state) từ âm thanh đầu vào, và một lớp tuyến tính ánh xạ các trạng thái ẩn đó thành ký tự.
Điều này có nghĩa là hệ thống gần như hoàn toàn dựa vào đầu vào âm học mà nó nhận được (các âm vị trong âm thanh) để dự đoán, nên có xu hướng chép lời theo kiểu phiên âm (ví dụ CHRISTMAUS). Nó ít coi trọng ngữ cảnh mô hình hoá ngôn ngữ của các chữ cái đứng trước và sau, nên dễ mắc lỗi chính tả theo âm. Một model thông minh hơn sẽ nhận ra CHRISTMAUS không phải là một từ hợp lệ trong từ vựng tiếng Anh, và sửa nó thành CHRISTMAS khi dự đoán. Dự đoán của chúng ta cũng thiếu hai tính năng lớn là chữ hoa/thường và dấu câu, làm hạn chế tính hữu dụng của bản chép lời trong các ứng dụng thực tế.
Chuyển sang Seq2Seq
Đến lượt model Seq2Seq! Như đã trình bày ở Unit 3, model Seq2Seq gồm một encoder và một decoder liên kết với nhau qua cơ chế cross-attention. Encoder đóng vai trò như trước, tính toán biểu diễn trạng thái ẩn của âm thanh đầu vào, còn decoder đóng vai trò một model ngôn ngữ. Decoder xử lý toàn bộ chuỗi biểu diễn trạng thái ẩn từ encoder và sinh ra bản chép lời tương ứng. Nhờ có ngữ cảnh toàn cục của âm thanh đầu vào, decoder có thể dùng ngữ cảnh mô hình hoá ngôn ngữ khi dự đoán, sửa lỗi chính tả ngay trong lúc sinh và nhờ đó tránh được vấn đề dự đoán theo âm.
Model Seq2Seq có hai nhược điểm:
- Về bản chất, chúng giải mã chậm hơn, vì quá trình giải mã diễn ra từng bước một thay vì tất cả cùng lúc
- Chúng cần nhiều dữ liệu hơn, đòi hỏi lượng dữ liệu huấn luyện lớn hơn đáng kể mới hội tụ
Đặc biệt, nhu cầu về lượng lớn dữ liệu huấn luyện đã là nút thắt cổ chai trong sự phát triển của kiến trúc Seq2Seq cho giọng nói. Dữ liệu giọng nói có gán nhãn rất khó kiếm, với các bộ dữ liệu có chú thích lớn nhất lúc đó chỉ khoảng 10.000 giờ. Mọi thứ thay đổi vào năm 2022 khi Whisper ra mắt. Whisper là model huấn luyện sẵn cho nhận dạng giọng nói, được công bố vào tháng 9 năm 2022 bởi nhóm tác giả Alec Radford và cộng sự tại OpenAI. Khác với các model CTC đi trước vốn được pre-train hoàn toàn trên dữ liệu âm thanh chưa gán nhãn, Whisper được pre-train trên một lượng khổng lồ dữ liệu âm thanh–bản chép lời có gán nhãn, chính xác là 680.000 giờ.
Đây là lượng dữ liệu lớn hơn một bậc so với dữ liệu âm thanh chưa gán nhãn dùng để huấn luyện Wav2Vec 2.0 (60.000 giờ). Hơn nữa, 117.000 giờ trong số dữ liệu pre-training này là dữ liệu đa ngôn ngữ (hay "không phải tiếng Anh"). Kết quả là các checkpoint có thể áp dụng cho hơn 96 ngôn ngữ, nhiều trong số đó được xem là ít tài nguyên (low-resource), nghĩa là ngôn ngữ đó thiếu một kho dữ liệu lớn phù hợp cho huấn luyện.
Khi mở rộng tới 680.000 giờ dữ liệu pre-training có gán nhãn, các model Whisper thể hiện khả năng tổng quát hoá mạnh trên nhiều bộ dữ liệu và lĩnh vực. Các checkpoint huấn luyện sẵn đạt kết quả cạnh tranh với các hệ thống tốt nhất hiện có, với tỉ lệ lỗi từ (word error rate, WER) gần 3% trên tập test-clean của LibriSpeech và đạt mức tốt nhất mới trên TED-LIUM với WER 4,7% (xem Bảng 8 trong bài báo Whisper).
Đặc biệt quan trọng là khả năng xử lý mẫu âm thanh dài của Whisper, độ bền vững trước nhiễu đầu vào và khả năng dự đoán bản chép lời có chữ hoa/thường và dấu câu. Điều này khiến nó trở thành ứng viên khả thi cho các hệ thống nhận dạng giọng nói thực tế.
Phần còn lại của bài sẽ hướng dẫn bạn cách dùng các model Whisper huấn luyện sẵn cho nhận dạng giọng nói với Transformers. Trong nhiều tình huống, các checkpoint Whisper huấn luyện sẵn cực kỳ hiệu quả và cho kết quả rất tốt, vì vậy bạn nên thử dùng checkpoint huấn luyện sẵn như bước đầu tiên khi giải quyết bất kỳ bài toán nhận dạng giọng nói nào. Thông qua fine-tuning, các checkpoint huấn luyện sẵn có thể được điều chỉnh cho bộ dữ liệu và ngôn ngữ cụ thể để cải thiện thêm kết quả. Chúng ta sẽ minh hoạ cách làm điều này trong phần fine-tuning sắp tới.
Checkpoint Whisper có năm cấu hình với kích thước model khác nhau. Bốn cấu hình nhỏ nhất được huấn luyện trên dữ liệu chỉ tiếng Anh hoặc dữ liệu đa ngôn ngữ. Checkpoint lớn nhất chỉ có bản đa ngôn ngữ. Cả chín checkpoint huấn luyện sẵn đều có trên Hugging Face Hub. Các checkpoint được tóm tắt trong bảng dưới đây, kèm link tới model trên Hub. "VRAM" là bộ nhớ GPU cần để chạy model với batch size tối thiểu là 1. "Rel Speed" là tốc độ tương đối của checkpoint so với model lớn nhất. Dựa vào thông tin này, bạn có thể chọn checkpoint phù hợp nhất với phần cứng của mình.
| Size | Parameters | VRAM / GB | Rel Speed | English-only | Multilingual |
|---|---|---|---|---|---|
| tiny | 39 M | 1.4 | 32 | ✓ | ✓ |
| base | 74 M | 1.5 | 16 | ✓ | ✓ |
| small | 244 M | 2.3 | 6 | ✓ | ✓ |
| medium | 769 M | 4.2 | 2 | ✓ | ✓ |
| large | 1550 M | 7.5 | 1 | x | ✓ |
Hãy tải checkpoint Whisper Base, có kích thước tương đương checkpoint Wav2Vec2 đã dùng ở trên. Để chuẩn bị cho phần nhận dạng giọng nói đa ngôn ngữ, chúng ta sẽ tải biến thể đa ngôn ngữ của checkpoint base. Chúng ta cũng tải model lên GPU nếu có, không thì dùng CPU. Sau đó pipeline() sẽ lo việc chuyển mọi đầu vào / đầu ra từ CPU sang GPU khi cần:
import torch
from transformers import pipeline

device = "cuda:0" if torch.cuda.is_available() else "cpu"
pipe = pipeline(
    "automatic-speech-recognition", model="openai/whisper-base", device=device
)
Tuyệt! Giờ hãy chép lời đoạn âm thanh như trước. Thay đổi duy nhất là chúng ta truyền thêm một tham số, max_new_tokens, cho model biết số token tối đa được sinh ra khi dự đoán:
pipe(sample["audio"], max_new_tokens=256)
Output:
{'text': ' He tells us that at this festive season of the year, with Christmas and roast beef looming before us, similarly is drawn from eating and its results occur most readily to the mind.'}
Khá dễ! Điều đầu tiên bạn sẽ nhận thấy là có cả chữ hoa/thường lẫn dấu câu. Chỉ riêng điều này đã khiến bản chép lời dễ đọc hơn hẳn so với bản chép lời không phân biệt hoa/thường và không có dấu câu của Wav2Vec2. Hãy đặt bản chép lời cạnh văn bản đích:
Target:     HE TELLS US THAT AT THIS FESTIVE SEASON OF THE YEAR WITH CHRISTMAS AND ROAST BEEF LOOMING BEFORE US SIMILES DRAWN FROM EATING AND ITS RESULTS OCCUR MOST READILY TO THE MIND
Prediction: He tells us that at this festive season of the year, with **Christmas** and **roast** beef looming before us, **similarly** is drawn from eating and its results occur most readily to the mind.
Whisper đã sửa rất tốt các lỗi theo âm mà chúng ta thấy ở Wav2Vec2: cả Christmas và roast đều được viết đúng chính tả. Model vẫn gặp khó với SIMILES, bị chép sai thành similarly, nhưng lần này dự đoán là một từ hợp lệ trong từ vựng tiếng Anh. Dùng checkpoint Whisper lớn hơn có thể giúp giảm thêm lỗi chép lời, đổi lại cần nhiều tài nguyên tính toán hơn và thời gian chép lời lâu hơn.
Chúng ta đã được hứa hẹn một model xử lý được 96 ngôn ngữ, vậy hãy tạm rời nhận dạng giọng nói tiếng Anh và đi ra thế giới! Bộ dữ liệu Multilingual LibriSpeech (MLS) là phiên bản đa ngôn ngữ của LibriSpeech, với dữ liệu âm thanh có gán nhãn ở sáu ngôn ngữ. Chúng ta sẽ tải một mẫu từ phần tiếng Tây Ban Nha của MLS, dùng chế độ streaming để không phải tải toàn bộ bộ dữ liệu:
dataset = load_dataset(
    "facebook/multilingual_librispeech", "spanish", split="validation", streaming=True
)
sample = next(iter(dataset))
Một lần nữa, chúng ta xem bản chép lời văn bản và nghe đoạn âm thanh:
print(sample["text"])
Audio(sample["audio"]["array"], rate=sample["audio"]["sampling_rate"])
Output:
entonces te delelitarás en jehová y yo te haré subir sobre las alturas de la tierra y te daré á comer la heredad de jacob tu padre porque la boca de jehová lo ha hablado
Đây là văn bản đích mà bản chép lời của Whisper hướng tới. Dù vậy, giờ chúng ta biết là có thể làm tốt hơn thế, vì model của chúng ta còn dự đoán cả dấu câu và chữ hoa/thường, vốn không có trong văn bản tham chiếu. Hãy đưa mẫu âm thanh vào pipeline để lấy dự đoán văn bản. Cần lưu ý là pipeline tiêu thụ dictionary đầu vào âm thanh mà chúng ta truyền vào, nghĩa là không thể dùng lại dictionary đó. Để tránh điều này, chúng ta sẽ truyền một bản sao của mẫu âm thanh, để có thể dùng lại cùng mẫu âm thanh trong các ví dụ code tiếp theo:
pipe(sample["audio"].copy(), max_new_tokens=256, generate_kwargs={"task": "transcribe"})
Output:
{'text': ' Entonces te deleitarás en Jehová y yo te haré subir sobre las alturas de la tierra y te daré a comer la heredad de Jacob tu padre porque la boca de Jehová lo ha hablado.'}
Tuyệt: kết quả rất giống văn bản tham chiếu (có thể nói là tốt hơn vì có dấu câu và chữ hoa/thường!). Bạn sẽ để ý rằng chúng ta đã truyền "task" dưới dạng tham số từ khoá cho generate (generate kwarg). Đặt "task" thành "transcribe" buộc Whisper thực hiện tác vụ nhận dạng giọng nói, trong đó âm thanh được chép lời sang cùng ngôn ngữ với lời nói. Whisper cũng có thể thực hiện tác vụ liên quan chặt chẽ là dịch giọng nói (speech translation), trong đó âm thanh tiếng Tây Ban Nha được dịch thành văn bản tiếng Anh. Để làm vậy, chúng ta đặt "task" thành "translate":
pipe(sample["audio"], max_new_tokens=256, generate_kwargs={"task": "translate"})
Output:
{'text': ' So you will choose in Jehovah and I will raise you on the heights of the earth and I will give you the honor of Jacob to your father because the voice of Jehovah has spoken to you.'}
Giờ chúng ta đã biết cách chuyển qua lại giữa nhận dạng giọng nói và dịch giọng nói, nên có thể chọn tác vụ tuỳ nhu cầu. Hoặc là nhận dạng từ âm thanh ở ngôn ngữ X thành văn bản cùng ngôn ngữ X (ví dụ âm thanh tiếng Tây Ban Nha thành văn bản tiếng Tây Ban Nha), hoặc là dịch từ âm thanh ở bất kỳ ngôn ngữ X nào thành văn bản tiếng Anh (ví dụ âm thanh tiếng Tây Ban Nha thành văn bản tiếng Anh).
Để đọc thêm về cách tham số "task" được dùng để kiểm soát đặc tính của văn bản sinh ra, hãy xem model card của model Whisper base.
Chép lời âm thanh dài và timestamp
Đến giờ, chúng ta mới tập trung chép lời các mẫu âm thanh ngắn dưới 30 giây. Chúng ta đã nhắc rằng một điểm hấp dẫn của Whisper là khả năng làm việc với mẫu âm thanh dài. Giờ chúng ta sẽ xử lý tác vụ này!
Hãy tạo một file âm thanh dài bằng cách nối các mẫu liên tiếp trong bộ dữ liệu MLS. Vì MLS được tạo bằng cách cắt các bản ghi sách nói dài thành các đoạn ngắn hơn, nối các mẫu lại là một cách để dựng lại những đoạn sách nói dài hơn. Do đó, âm thanh thu được sẽ mạch lạc trên toàn bộ mẫu.
Chúng ta đặt độ dài âm thanh mục tiêu là 5 phút, và dừng nối mẫu khi đạt tới giá trị này:
import numpy as np

target_length_in_m = 5

# convert from minutes to seconds (* 60) to num samples (* sampling rate)
sampling_rate = pipe.feature_extractor.sampling_rate
target_length_in_samples = target_length_in_m * 60 * sampling_rate

# iterate over our streaming dataset, concatenating samples until we hit our target
long_audio = []
for sample in dataset:
    long_audio.extend(sample["audio"]["array"])
    if len(long_audio) > target_length_in_samples:
        break

long_audio = np.asarray(long_audio)

# how did we do?
seconds = len(long_audio) / 16000
minutes, seconds = divmod(seconds, 60)
print(f"Length of audio sample is {minutes} minutes {seconds:.2f} seconds")
Output:
Length of audio sample is 5.0 minutes 17.22 seconds
Được rồi! Có 5 phút 17 giây âm thanh cần chép lời. Có hai vấn đề khi đưa trực tiếp mẫu âm thanh dài này vào model:
- Whisper về bản chất được thiết kế để làm việc với mẫu 30 giây: mọi thứ ngắn hơn 30 giây được đệm thêm khoảng lặng cho đủ 30 giây, mọi thứ dài hơn 30 giây bị cắt còn 30 giây bằng cách bỏ phần âm thanh thừa, nên nếu đưa trực tiếp âm thanh vào, chúng ta chỉ nhận được bản chép lời của 30 giây đầu
- Bộ nhớ trong mạng transformer tăng theo bình phương độ dài chuỗi: tăng gấp đôi độ dài đầu vào thì nhu cầu bộ nhớ tăng gấp bốn, nên đưa vào file âm thanh siêu dài chắc chắn sẽ gây lỗi hết bộ nhớ (out-of-memory, OOM)
Cách chép lời âm thanh dài hoạt động trong Transformers là chia đoạn (chunking) âm thanh đầu vào thành các đoạn nhỏ hơn, dễ xử lý hơn. Mỗi đoạn chồng lấn một chút với đoạn trước đó. Điều này cho phép ghép chính xác các đoạn lại với nhau ở ranh giới, vì chúng ta có thể tìm phần chồng lấn giữa các đoạn và gộp bản chép lời tương ứng:
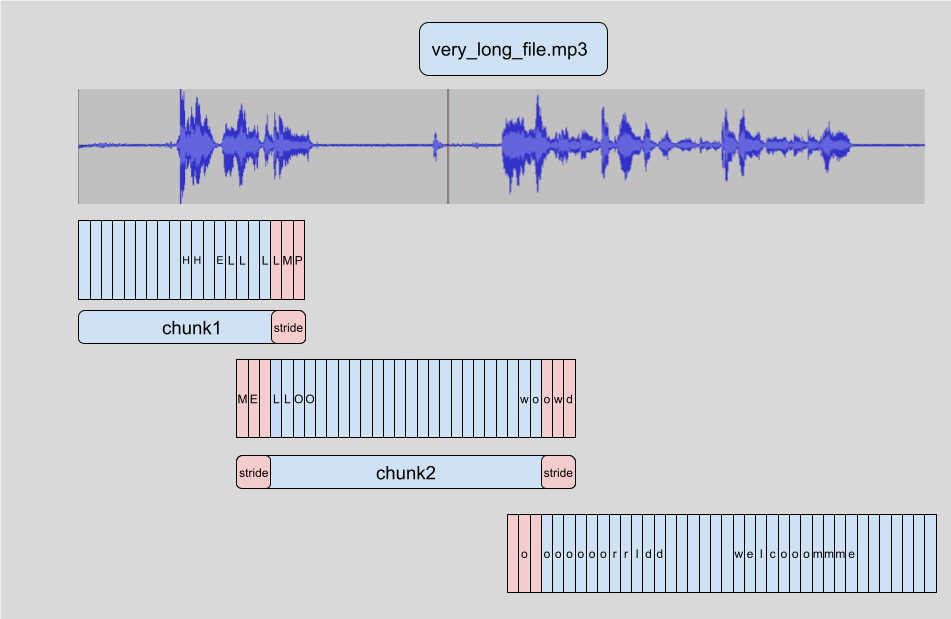
Ưu điểm của việc chia đoạn là chúng ta không cần kết quả của đoạn i để chép lời đoạn tiếp theo i + 1. Việc ghép được thực hiện ở ranh giới các đoạn sau khi đã chép lời xong tất cả các đoạn, nên thứ tự chép lời các đoạn không quan trọng. Thuật toán hoàn toàn không trạng thái (stateless), nên chúng ta thậm chí có thể xử lý đoạn i + 1 cùng lúc với đoạn i! Điều này cho phép chúng ta gom lô (batch) các đoạn và chạy chúng qua model song song, giúp tăng tốc tính toán rất nhiều so với chép lời tuần tự. Để đọc thêm về chia đoạn trong Transformers, bạn có thể xem bài blog này.
Để bật chép lời âm thanh dài, chúng ta phải thêm một tham số khi gọi pipeline. Tham số này, chunk_length_s, quy định độ dài các đoạn được chia, tính bằng giây. Với Whisper, đoạn 30 giây là tối ưu, vì nó khớp với độ dài đầu vào mà Whisper mong đợi.
Để bật gom lô, chúng ta cần truyền tham số batch_size vào pipeline. Kết hợp tất cả lại, chúng ta có thể chép lời mẫu âm thanh dài với chia đoạn và gom lô như sau:
pipe(
    long_audio,
    max_new_tokens=256,
    generate_kwargs={"task": "transcribe"},
    chunk_length_s=30,
    batch_size=8,
)
Output:
{'text': ' Entonces te deleitarás en Jehová, y yo te haré subir sobre las alturas de la tierra, y te daré a comer la
heredad de Jacob tu padre, porque la boca de Jehová lo ha hablado. nosotros curados. Todos nosotros nos descarriamos
como bejas, cada cual se apartó por su camino, mas Jehová cargó en él el pecado de todos nosotros...
Chúng ta sẽ không in toàn bộ output ở đây vì nó khá dài (tổng cộng 312 từ)! Trên GPU V100 16GB, dòng lệnh trên mất khoảng 3,45 giây để chạy, khá tốt với một mẫu âm thanh dài 317 giây. Trên CPU, thời gian sẽ gần 30 giây.
Whisper cũng có thể dự đoán timestamp (mốc thời gian) ở cấp đoạn cho dữ liệu âm thanh. Các timestamp này cho biết thời điểm bắt đầu và kết thúc của một đoạn âm thanh ngắn, và đặc biệt hữu ích để căn bản chép lời khớp với âm thanh đầu vào. Giả sử chúng ta muốn làm phụ đề cho một video: chúng ta cần các timestamp này để biết phần nào của bản chép lời ứng với đoạn video nào, nhằm hiển thị đúng phần chép lời vào đúng thời điểm.
Bật dự đoán timestamp rất đơn giản, chỉ cần đặt tham số return_timestamps=True. Timestamp tương thích với cả chia đoạn lẫn gom lô mà chúng ta đã dùng ở trên, nên chỉ cần thêm tham số timestamp vào lời gọi trước đó:
pipe(
    long_audio,
    max_new_tokens=256,
    generate_kwargs={"task": "transcribe"},
    chunk_length_s=30,
    batch_size=8,
    return_timestamps=True,
)["chunks"]
Output:
[{'timestamp': (0.0, 26.4),
  'text': ' Entonces te deleitarás en Jehová, y yo te haré subir sobre las alturas de la tierra, y te daré a comer la heredad de Jacob tu padre, porque la boca de Jehová lo ha hablado. nosotros curados. Todos nosotros nos descarriamos como bejas, cada cual se apartó por su camino,'},
 {'timestamp': (26.4, 32.48),
  'text': ' mas Jehová cargó en él el pecado de todos nosotros. No es que partas tu pan con el'},
 {'timestamp': (32.48, 38.4),
  'text': ' hambriento y a los hombres herrantes metas en casa, que cuando vieres al desnudo lo cubras y no'},
 ...
Thế là xong! Chúng ta đã có văn bản dự đoán cùng các timestamp tương ứng.
Tóm tắt
Whisper là một model huấn luyện sẵn mạnh cho nhận dạng và dịch giọng nói. So với Wav2Vec2, nó có độ chính xác chép lời cao hơn, với output có dấu câu và chữ hoa/thường. Nó có thể dùng để chép lời tiếng Anh cũng như 96 ngôn ngữ khác, cả với đoạn âm thanh ngắn lẫn đoạn dài hơn nhờ chia đoạn. Những đặc tính này khiến nó trở thành model khả thi cho nhiều tác vụ nhận dạng và dịch giọng nói mà không cần fine-tuning. Phương thức pipeline() cung cấp cách dễ dàng để chạy suy luận (inference) chỉ bằng một lời gọi API, đồng thời kiểm soát được các dự đoán sinh ra.
Dù Whisper hoạt động cực kỳ tốt trên nhiều ngôn ngữ nhiều tài nguyên (high-resource), độ chính xác chép lời và dịch của nó thấp hơn với ngôn ngữ ít tài nguyên, tức là những ngôn ngữ có ít dữ liệu huấn luyện sẵn có. Hiệu năng cũng khác nhau giữa các giọng địa phương và phương ngữ của một số ngôn ngữ, bao gồm độ chính xác thấp hơn với người nói thuộc các giới tính, chủng tộc, độ tuổi hoặc tiêu chí nhân khẩu học khác nhau (xem bài báo Whisper).
Để tăng hiệu năng với ngôn ngữ, giọng địa phương hoặc phương ngữ ít tài nguyên, chúng ta có thể lấy model Whisper huấn luyện sẵn và huấn luyện nó trên một kho dữ liệu nhỏ được chọn lọc phù hợp, trong một quá trình gọi là fine-tuning. Chúng ta sẽ cho thấy rằng chỉ với khoảng mười giờ dữ liệu bổ sung, có thể cải thiện hiệu năng của model Whisper hơn 100% trên một ngôn ngữ ít tài nguyên. Ở phần tiếp theo, chúng ta sẽ tìm hiểu quy trình chọn bộ dữ liệu cho fine-tuning.
Nguồn
- Dịch và biên tập từ huggingface/audio-transformers-course · chapters/en/chapter5/asr_models.mdx, giấy phép Apache-2.0.