Trong phần này, chúng ta sẽ xem cách dùng Transformer để chuyển lời nói thành văn bản, một tác vụ được gọi là nhận dạng giọng nói (speech recognition).
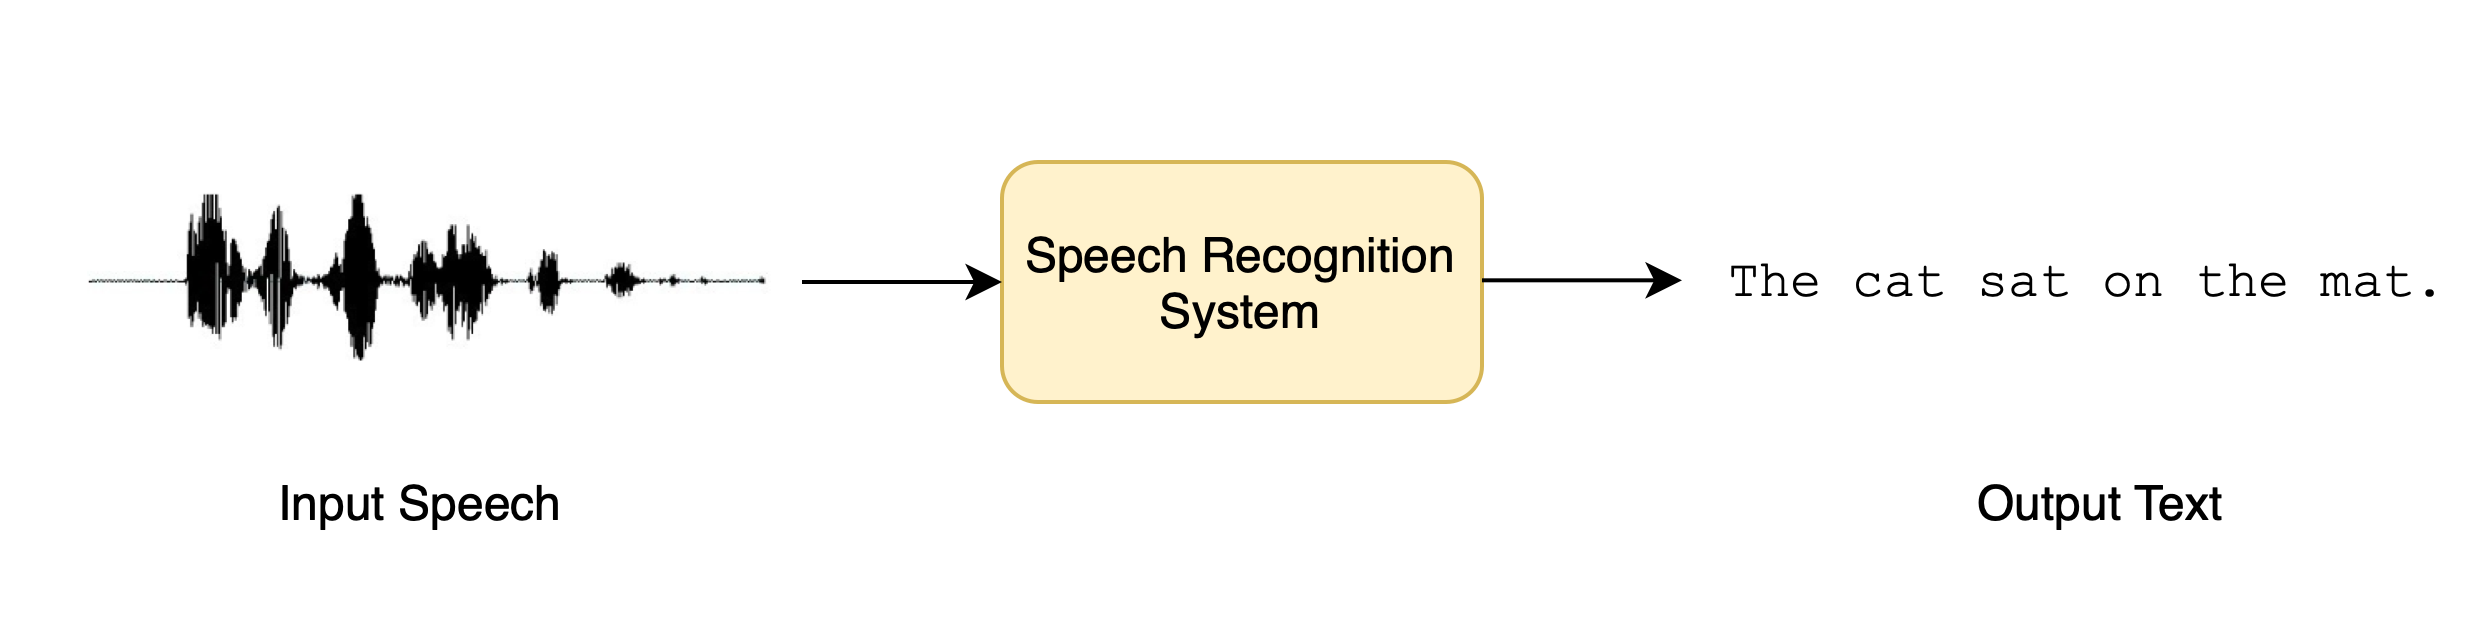
Nhận dạng giọng nói là gì
Nhận dạng giọng nói, còn gọi là nhận dạng giọng nói tự động (automatic speech recognition, ASR) hay chuyển giọng nói thành văn bản (speech-to-text, STT), là một trong những tác vụ xử lý ngôn ngữ nói phổ biến và thú vị nhất. Nó được dùng trong rất nhiều ứng dụng, gồm đọc chính tả, trợ lý giọng nói, tạo phụ đề video và ghi biên bản cuộc họp.
Có lẽ bạn đã dùng hệ thống nhận dạng giọng nói rất nhiều lần mà không nhận ra! Hãy nghĩ tới trợ lý số trên điện thoại của bạn (Siri, Google Assistant, Alexa). Khi bạn dùng các trợ lý này, việc đầu tiên chúng làm là chép lời nói của bạn thành văn bản viết, sẵn sàng cho các tác vụ phía sau (như tìm thông tin thời tiết cho bạn).
Hãy thử bản demo nhận dạng giọng nói tại Space course-demos-whisper-small. Bạn có thể tự ghi âm bằng micro, hoặc kéo thả một mẫu âm thanh để chép lời.
Vì sao nhận dạng giọng nói khó
Nhận dạng giọng nói là một tác vụ khó vì nó đòi hỏi hiểu biết kết hợp về cả âm thanh lẫn văn bản. Âm thanh đầu vào có thể có nhiều tiếng ồn nền và do những người nói với giọng địa phương khác nhau phát ra, khiến việc tách lời nói trở nên khó khăn. Văn bản viết có thể chứa những ký tự không có âm thanh tương ứng, như dấu câu, vốn khó suy ra chỉ từ âm thanh. Đây đều là những trở ngại chúng ta phải vượt qua khi xây dựng hệ thống nhận dạng giọng nói hiệu quả!
Bạn sẽ học gì
Giờ chúng ta đã định nghĩa xong tác vụ, hãy bắt đầu tìm hiểu nhận dạng giọng nói chi tiết hơn. Khi kết thúc phần này, bạn sẽ có hiểu biết nền tảng vững về các model nhận dạng giọng nói được huấn luyện sẵn (pre-trained) hiện có và cách dùng chúng với thư viện Transformers. Bạn cũng sẽ biết quy trình fine-tuning một model ASR cho một lĩnh vực hoặc ngôn ngữ tuỳ chọn, giúp bạn xây dựng một hệ thống hiệu quả cho bất kỳ tác vụ nào bạn gặp. Bạn sẽ có thể giới thiệu model của mình với bạn bè và gia đình bằng cách xây dựng một bản demo trực tiếp, nhận bất kỳ lời nói nào và chuyển nó thành văn bản!
Cụ thể, chúng ta sẽ đi qua:
- Các model được huấn luyện sẵn cho nhận dạng giọng nói
- Chọn bộ dữ liệu
- Đánh giá và các chỉ số cho nhận dạng giọng nói
- Cách fine-tuning hệ thống ASR bằng Trainer API
- Xây dựng bản demo
- Bài tập thực hành
Nguồn
- Dịch và biên tập từ huggingface/audio-transformers-course · chapters/en/chapter5/introduction.mdx, giấy phép Apache-2.0.