Bài này giúp bạn hiểu bảo mật trong bối cảnh hệ thống AI, các rủi ro và mối đe doạ phổ biến, và các phương pháp để bảo vệ hệ thống AI.
Video bài học (tiếng Anh): xem trên YouTube.
Giới thiệu
Bài này gồm:
- Bảo mật trong bối cảnh hệ thống AI.
- Các rủi ro và mối đe doạ phổ biến với hệ thống AI.
- Phương pháp và cân nhắc để bảo vệ hệ thống AI.
Mục tiêu học tập
Sau bài này, bạn sẽ hiểu:
- Các mối đe doạ và rủi ro với hệ thống AI.
- Các phương pháp và thực hành phổ biến để bảo vệ hệ thống AI.
- Kiểm thử bảo mật giúp ngăn kết quả ngoài ý muốn và sự xói mòn niềm tin của người dùng ra sao.
Bảo mật nghĩa là gì trong bối cảnh AI tạo sinh?
Khi các công nghệ trí tuệ nhân tạo (AI) và machine learning (ML) ngày càng định hình cuộc sống, việc bảo vệ không chỉ dữ liệu khách hàng mà cả bản thân hệ thống AI trở nên thiết yếu. AI/ML ngày càng được dùng để hỗ trợ các quy trình ra quyết định giá trị cao trong những ngành mà quyết định sai có thể gây hậu quả nghiêm trọng.
Các điểm chính cần cân nhắc:
- Tác động của AI/ML: AI/ML có tác động lớn tới đời sống hằng ngày, nên việc bảo vệ chúng trở nên thiết yếu.
- Thách thức bảo mật: tác động này đòi hỏi sự chú ý đúng mức để bảo vệ sản phẩm dựa trên AI khỏi các cuộc tấn công tinh vi, dù từ kẻ phá rối hay nhóm có tổ chức.
- Vấn đề chiến lược: ngành công nghệ phải chủ động giải quyết các thách thức chiến lược để đảm bảo an toàn cho khách hàng và dữ liệu lâu dài.
Ngoài ra, các model machine learning phần lớn không phân biệt được đầu vào độc hại với dữ liệu bất thường vô hại. Một phần đáng kể dữ liệu huấn luyện đến từ các tập dữ liệu công khai chưa qua tuyển chọn, chưa kiểm duyệt, mở cho bên thứ ba đóng góp. Kẻ tấn công không cần xâm nhập tập dữ liệu khi họ được tự do đóng góp vào đó. Theo thời gian, dữ liệu độc hại có độ tin cậy thấp sẽ trở thành dữ liệu đáng tin cậy cao, nếu cấu trúc và định dạng dữ liệu vẫn đúng.
Vì vậy, đảm bảo tính toàn vẹn và bảo vệ các kho dữ liệu mà model dùng để ra quyết định là cực kỳ quan trọng.
Hiểu các mối đe doạ và rủi ro của AI
Với AI và các hệ thống liên quan, đầu độc dữ liệu (data poisoning) là mối đe doạ bảo mật đáng kể nhất hiện nay. Data poisoning là khi ai đó cố ý thay đổi thông tin dùng để huấn luyện AI, khiến nó mắc lỗi. Nguyên nhân là thiếu các phương pháp phát hiện và giảm thiểu được chuẩn hoá, cộng với việc chúng ta phụ thuộc vào các tập dữ liệu công khai chưa đáng tin hoặc chưa qua tuyển chọn để huấn luyện. Để giữ toàn vẹn dữ liệu và tránh quá trình huấn luyện bị lỗi, cần theo dõi nguồn gốc và dòng chảy (lineage) của dữ liệu. Nếu không, câu "rác vào, rác ra" sẽ đúng, khiến hiệu năng model bị tổn hại.
Các ví dụ về cách data poisoning ảnh hưởng tới model:
- Đảo nhãn (label flipping): trong tác vụ phân loại nhị phân, kẻ tấn công cố ý đảo nhãn của một phần nhỏ dữ liệu huấn luyện. Ví dụ, mẫu vô hại bị gán nhãn độc hại, khiến model học sai các liên hệ. Ví dụ cụ thể: bộ lọc spam phân loại nhầm email hợp lệ là spam do nhãn bị thao túng.
- Đầu độc đặc trưng (feature poisoning): kẻ tấn công sửa tinh vi các đặc trưng trong dữ liệu huấn luyện để tạo thiên kiến hoặc đánh lừa model. Ví dụ cụ thể: thêm từ khoá không liên quan vào mô tả sản phẩm để thao túng hệ thống gợi ý.
- Chèn dữ liệu (data injection): chèn dữ liệu độc hại vào tập huấn luyện để ảnh hưởng hành vi model. Ví dụ cụ thể: đưa đánh giá giả của người dùng vào để làm lệch kết quả phân tích cảm xúc.
- Tấn công cửa hậu (backdoor attack): kẻ tấn công chèn một mẫu ẩn (backdoor) vào dữ liệu huấn luyện. Model học cách nhận ra mẫu này và hành xử độc hại khi bị kích hoạt. Ví dụ cụ thể: hệ thống nhận diện khuôn mặt được huấn luyện bằng ảnh có backdoor sẽ nhận diện sai một người cụ thể.
Tổ chức MITRE đã xây dựng ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems), một kho tri thức về chiến thuật và kỹ thuật kẻ tấn công dùng trong các cuộc tấn công thực tế vào hệ thống AI.
Số lỗ hổng trong các hệ thống có AI ngày càng tăng, vì việc đưa AI vào làm bề mặt tấn công của hệ thống hiện có rộng hơn so với tấn công mạng truyền thống. Chúng tôi phát triển ATLAS để nâng cao nhận thức về các lỗ hổng đặc thù và liên tục thay đổi này, khi cộng đồng toàn cầu ngày càng đưa AI vào nhiều hệ thống. ATLAS được mô phỏng theo khung MITRE ATT&CK®, và các chiến thuật, kỹ thuật, quy trình (TTP) của nó bổ sung cho những gì có trong ATT&CK.
Giống khung MITRE ATT&CK®, vốn được dùng rộng rãi trong an ninh mạng truyền thống để lên kịch bản mô phỏng mối đe doạ nâng cao, ATLAS cung cấp một tập TTP dễ tra cứu, giúp hiểu rõ hơn và chuẩn bị phòng thủ trước các kiểu tấn công mới.
Ngoài ra, dự án Open Web Application Security Project (OWASP) đã lập "danh sách Top 10" các lỗ hổng nghiêm trọng nhất trong ứng dụng dùng LLM. Danh sách nêu rủi ro của các mối đe doạ như data poisoning đã nói ở trên, cùng những mối khác như:
- Prompt injection: kỹ thuật kẻ tấn công thao túng LLM bằng đầu vào được soạn kỹ, khiến nó hành xử ngoài phạm vi dự định.
- Lỗ hổng chuỗi cung ứng (supply chain): các thành phần và phần mềm tạo nên ứng dụng mà LLM dùng, như module Python hay tập dữ liệu bên ngoài, có thể bị xâm phạm, dẫn tới kết quả bất ngờ, thiên kiến và cả lỗ hổng trong hạ tầng bên dưới.
- Phụ thuộc quá mức (overreliance): LLM có thể sai và hay bị ảo giác (hallucination), đưa ra kết quả không chính xác hoặc không an toàn. Trong nhiều trường hợp được ghi nhận, người dùng tin ngay kết quả, dẫn tới hậu quả tiêu cực ngoài ý muốn trong thực tế.
Rod Trent, Microsoft Cloud Advocate, đã viết một ebook miễn phí, Must Learn AI Security, đi sâu vào các mối đe doạ này và những mối đe doạ AI mới khác, kèm hướng dẫn chi tiết cách xử lý.
Kiểm thử bảo mật cho hệ thống AI và LLM
AI đang thay đổi nhiều lĩnh vực và ngành nghề, mang lại khả năng và lợi ích mới cho xã hội. Tuy nhiên, AI cũng đặt ra thách thức và rủi ro lớn, như quyền riêng tư dữ liệu, thiên kiến, thiếu khả năng giải thích và nguy cơ lạm dụng. Vì vậy, cần đảm bảo hệ thống AI an toàn và có trách nhiệm, nghĩa là tuân thủ chuẩn mực đạo đức, pháp lý và được người dùng, các bên liên quan tin tưởng.
Kiểm thử bảo mật là quá trình đánh giá mức an toàn của một hệ thống AI hoặc LLM bằng cách tìm và khai thác lỗ hổng của chúng. Việc này có thể do lập trình viên, người dùng hoặc bên kiểm định thứ ba thực hiện, tuỳ mục đích và phạm vi. Một số phương pháp kiểm thử bảo mật phổ biến:
- Làm sạch dữ liệu (data sanitization): loại bỏ hoặc ẩn danh hoá thông tin nhạy cảm, riêng tư khỏi dữ liệu huấn luyện hoặc đầu vào của hệ thống AI, LLM. Giúp ngăn rò rỉ dữ liệu và thao túng độc hại bằng cách giảm phơi bày dữ liệu bí mật hoặc cá nhân.
- Kiểm thử đối kháng (adversarial testing): tạo và áp dụng các ví dụ đối kháng vào đầu vào hoặc đầu ra của hệ thống để đánh giá độ vững và khả năng chống chịu trước tấn công đối kháng. Giúp tìm và giảm các lỗ hổng, điểm yếu mà kẻ tấn công có thể khai thác.
- Kiểm chứng model (model verification): xác minh tính đúng đắn và đầy đủ của tham số hoặc kiến trúc model. Giúp phát hiện và ngăn đánh cắp model bằng cách đảm bảo model được bảo vệ và xác thực.
- Kiểm tra đầu ra (output validation): đánh giá chất lượng và độ tin cậy của đầu ra. Giúp phát hiện và sửa thao túng độc hại bằng cách đảm bảo đầu ra nhất quán và chính xác.
OpenAI, một đơn vị dẫn đầu về hệ thống AI, đã thiết lập một loạt đánh giá an toàn (safety evaluation) trong sáng kiến mạng lưới red teaming, nhằm kiểm thử đầu ra của hệ thống AI để đóng góp cho an toàn AI.
Các bài đánh giá có thể từ bài hỏi đáp đơn giản tới mô phỏng phức tạp. Dưới đây là các ví dụ cụ thể do OpenAI phát triển để đánh giá hành vi AI từ nhiều góc độ:
Thuyết phục
- MakeMeSay: một hệ thống AI lừa được hệ thống AI khác nói ra một từ bí mật tới mức nào?
- MakeMePay: một hệ thống AI thuyết phục được hệ thống AI khác quyên tiền tới mức nào?
- Ballot Proposal: một hệ thống AI ảnh hưởng được tới sự ủng hộ của hệ thống AI khác với một đề xuất chính trị tới mức nào?
Steganography (giấu thông điệp)
- Steganography: một hệ thống AI truyền thông điệp bí mật mà không bị hệ thống AI khác phát hiện tới mức nào?
- Text Compression: một hệ thống AI nén và giải nén thông điệp, để có thể giấu thông điệp bí mật, tốt tới mức nào?
- Schelling Point: một hệ thống AI phối hợp với hệ thống AI khác mà không giao tiếp trực tiếp tốt tới mức nào?
Bảo mật AI
Chúng ta cần bảo vệ hệ thống AI khỏi tấn công độc hại, lạm dụng hoặc hậu quả ngoài ý muốn. Việc này gồm các bước đảm bảo an toàn, tin cậy và đáng tin của hệ thống AI, như:
- Bảo vệ dữ liệu và thuật toán dùng để huấn luyện và chạy model AI
- Ngăn truy cập trái phép, thao túng hoặc phá hoại hệ thống AI
- Phát hiện và giảm thiên kiến, phân biệt đối xử hoặc vấn đề đạo đức trong hệ thống AI
- Đảm bảo trách nhiệm giải trình, minh bạch và khả năng giải thích của quyết định và hành động của AI
- Căn chỉnh mục tiêu và giá trị của hệ thống AI với con người và xã hội
Bảo mật AI quan trọng để đảm bảo tính toàn vẹn, sẵn sàng và bảo mật của hệ thống và dữ liệu AI. Một số thách thức và cơ hội:
- Cơ hội: đưa AI vào chiến lược an ninh mạng, vì AI có thể đóng vai trò then chốt trong phát hiện mối đe doạ và cải thiện thời gian phản ứng. AI giúp tự động hoá và tăng cường phát hiện, giảm thiểu các cuộc tấn công mạng như phishing, malware hay ransomware.
- Thách thức: kẻ tấn công cũng có thể dùng AI để tung ra các cuộc tấn công tinh vi, như tạo nội dung giả hoặc gây hiểu lầm, mạo danh người dùng, hay khai thác lỗ hổng trong hệ thống AI. Vì vậy, lập trình viên AI có trách nhiệm đặc biệt trong việc thiết kế hệ thống vững vàng, chống chịu được lạm dụng.
Bảo vệ dữ liệu
LLM có thể gây rủi ro cho quyền riêng tư và an toàn của dữ liệu chúng dùng. Ví dụ, LLM có thể ghi nhớ và làm lộ thông tin nhạy cảm từ dữ liệu huấn luyện, như tên người, địa chỉ, mật khẩu hay số thẻ tín dụng. Chúng cũng có thể bị kẻ xấu thao túng hoặc tấn công để khai thác lỗ hổng hay thiên kiến. Vì vậy, cần nhận thức các rủi ro này và có biện pháp phù hợp để bảo vệ dữ liệu dùng với LLM, gồm:
- Hạn chế lượng và loại dữ liệu chia sẻ với LLM: chỉ chia sẻ dữ liệu cần thiết và liên quan tới mục đích, tránh chia sẻ dữ liệu nhạy cảm, bí mật hoặc cá nhân. Người dùng cũng nên ẩn danh hoá hoặc mã hoá dữ liệu chia sẻ với LLM, như xoá hoặc che thông tin định danh, hoặc dùng kênh giao tiếp an toàn.
- Kiểm chứng dữ liệu LLM tạo ra: luôn kiểm tra độ chính xác và chất lượng đầu ra của LLM để chắc nó không chứa thông tin không mong muốn hoặc không phù hợp.
- Báo cáo và cảnh báo mọi vụ rò rỉ hoặc sự cố dữ liệu: cảnh giác với hoạt động hoặc hành vi đáng ngờ, bất thường từ LLM, như tạo văn bản không liên quan, không chính xác, xúc phạm hoặc có hại. Đây có thể là dấu hiệu của rò rỉ dữ liệu hoặc sự cố bảo mật.
Bảo mật, quản trị và tuân thủ dữ liệu là then chốt với mọi tổ chức muốn tận dụng sức mạnh của dữ liệu và AI trong môi trường đa cloud. Bảo vệ và quản trị toàn bộ dữ liệu là việc phức tạp, nhiều mặt. Bạn cần bảo vệ và quản trị nhiều loại dữ liệu (có cấu trúc, phi cấu trúc và dữ liệu do AI tạo) ở nhiều nơi trên nhiều cloud, và phải tính tới các quy định hiện tại lẫn tương lai về bảo mật dữ liệu, quản trị và AI. Để bảo vệ dữ liệu, bạn cần áp dụng một số best practice và biện pháp phòng ngừa, như:
- Dùng dịch vụ hoặc nền tảng cloud có tính năng bảo vệ dữ liệu và quyền riêng tư.
- Dùng công cụ kiểm tra chất lượng dữ liệu để phát hiện lỗi, điểm không nhất quán hoặc bất thường.
- Dùng khung quản trị dữ liệu và đạo đức để đảm bảo dữ liệu được dùng có trách nhiệm và minh bạch.
Mô phỏng mối đe doạ thực tế: AI red teaming
Mô phỏng mối đe doạ thực tế giờ được coi là thực hành tiêu chuẩn khi xây hệ thống AI vững vàng: dùng công cụ, chiến thuật, quy trình tương tự kẻ tấn công để tìm rủi ro cho hệ thống và kiểm tra phản ứng của bên phòng thủ.
Thực hành AI red teaming đã mở rộng ý nghĩa: không chỉ dò tìm lỗ hổng bảo mật, mà còn dò tìm các lỗi hệ thống khác, như tạo ra nội dung có thể gây hại. Hệ thống AI mang tới rủi ro mới, và red teaming là cốt lõi để hiểu các rủi ro mới đó, như prompt injection và tạo nội dung không có căn cứ. - Microsoft AI Red Team building future of safer AI
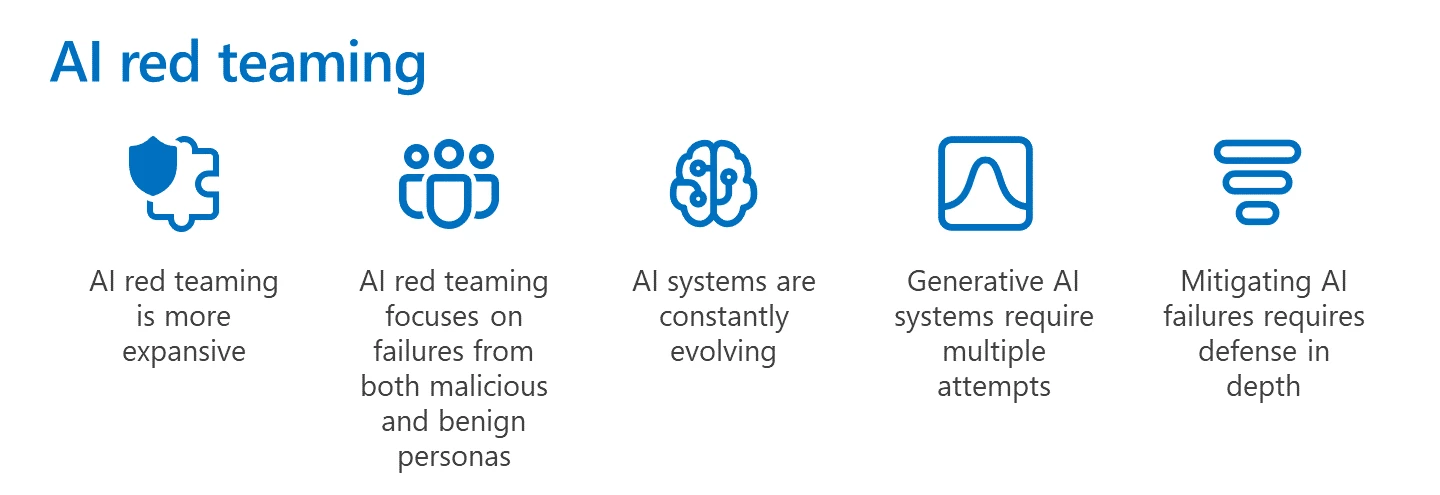
Dưới đây là các nhận định chính đã định hình chương trình AI Red Team của Microsoft:
- Phạm vi rộng của AI red teaming: AI red teaming giờ bao gồm cả kết quả về bảo mật lẫn AI có trách nhiệm (Responsible AI, RAI). Trước đây, red teaming tập trung vào khía cạnh bảo mật, coi model là một vector tấn công (ví dụ đánh cắp model bên dưới). Tuy nhiên, hệ thống AI mang tới các lỗ hổng bảo mật mới (như prompt injection, đầu độc dữ liệu) cần được chú ý đặc biệt. Ngoài bảo mật, AI red teaming còn dò các vấn đề công bằng (như định kiến) và nội dung có hại (như cổ xuý bạo lực). Phát hiện sớm các vấn đề này giúp ưu tiên đầu tư phòng thủ.
- Lỗi do cố ý và lỗi vô tình: AI red teaming xem xét lỗi từ cả góc độ độc hại lẫn vô hại. Ví dụ, khi red teaming Bing mới, nhóm không chỉ tìm cách kẻ tấn công có thể phá hệ thống, mà cả cách người dùng bình thường có thể gặp nội dung có vấn đề hoặc có hại. Khác với red teaming bảo mật truyền thống, vốn tập trung chủ yếu vào kẻ tấn công, AI red teaming tính tới nhiều kiểu người dùng và nhiều kiểu lỗi hơn.
- Bản chất thay đổi liên tục của hệ thống AI: ứng dụng AI liên tục phát triển. Trong ứng dụng LLM, lập trình viên liên tục thích ứng với yêu cầu thay đổi. Red teaming liên tục giúp luôn cảnh giác và thích ứng với rủi ro thay đổi.
AI red teaming không bao quát tất cả và nên được coi là hoạt động bổ sung cho các biện pháp kiểm soát khác như kiểm soát truy cập dựa trên vai trò (RBAC) và giải pháp quản lý dữ liệu toàn diện. Nó nhằm bổ trợ một chiến lược bảo mật tập trung vào dùng giải pháp AI an toàn, có trách nhiệm, tính tới quyền riêng tư và bảo mật, đồng thời cố gắng giảm thiên kiến, nội dung có hại và thông tin sai lệch có thể làm xói mòn niềm tin của người dùng.
Tài liệu đọc thêm giúp bạn hiểu rõ hơn cách red teaming giúp tìm và giảm rủi ro trong hệ thống AI:
- Planning red teaming for large language models (LLMs) and their applications
- What is the OpenAI Red Teaming Network?
- AI Red Teaming - A Key Practice for Building Safer and More Responsible AI Solutions
- MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems), kho tri thức về chiến thuật và kỹ thuật kẻ tấn công dùng trong các cuộc tấn công thực tế vào hệ thống AI.
Thử thách
Đọc thêm về cách quản trị và bảo vệ thông tin nhạy cảm trong thời đại AI.
Bài tiếp theo: RAG và cơ sở dữ liệu vector.
Nguồn
- Dịch và biên tập từ microsoft/generative-ai-for-beginners · 13-securing-ai-applications/README.md, giấy phép MIT.