Ở bài ứng dụng tìm kiếm, chúng ta đã lướt qua cách tích hợp dữ liệu riêng vào mô hình ngôn ngữ lớn (LLM). Bài này đi sâu hơn vào việc neo (grounding) dữ liệu của bạn trong ứng dụng LLM, cơ chế của quá trình đó và các cách lưu dữ liệu, cả embedding lẫn văn bản.
Giới thiệu
Bài này gồm:
- Giới thiệu RAG: nó là gì và vì sao được dùng trong AI.
- Hiểu cơ sở dữ liệu vector (vector database) là gì và tạo một cơ sở dữ liệu cho ứng dụng.
- Ví dụ thực tế về cách tích hợp RAG vào ứng dụng.
Mục tiêu học tập
Sau bài này, bạn sẽ có thể:
- Giải thích tầm quan trọng của RAG trong truy xuất và xử lý dữ liệu.
- Thiết lập ứng dụng RAG và neo dữ liệu của bạn vào LLM.
- Tích hợp hiệu quả RAG và cơ sở dữ liệu vector trong ứng dụng LLM.
Tình huống: tăng cường LLM bằng dữ liệu riêng
Trong bài này, chúng ta muốn đưa ghi chú riêng vào startup giáo dục, để chatbot có thêm thông tin về các môn học. Nhờ các ghi chú này, người học sẽ học tốt hơn, hiểu các chủ đề và ôn thi dễ hơn. Để dựng tình huống, chúng ta dùng:
Azure OpenAI:LLM dùng để tạo chatbotAI for beginners' lesson on Neural Networks: bài học về mạng nơ-ron trong chương trình AI for Beginners, là dữ liệu dùng để neo LLMAzure AI SearchvàAzure Cosmos DB:cơ sở dữ liệu vector để lưu dữ liệu và tạo chỉ mục tìm kiếm
Người dùng có thể tạo quiz luyện tập từ ghi chú, flashcard ôn tập và tóm tắt ghi chú thành bản tổng quan ngắn gọn. Trước hết, hãy xem RAG là gì và hoạt động ra sao.
Retrieval Augmented Generation (RAG)
Chatbot dùng LLM xử lý prompt của người dùng để tạo câu trả lời. Nó được thiết kế để tương tác và trò chuyện về rất nhiều chủ đề. Tuy nhiên, câu trả lời bị giới hạn bởi ngữ cảnh được cung cấp và dữ liệu huấn luyện nền tảng. Ví dụ, mốc kiến thức của GPT-4 là tháng 9/2021, nghĩa là nó không biết các sự kiện xảy ra sau thời điểm đó. Ngoài ra, dữ liệu huấn luyện LLM không gồm thông tin bí mật như ghi chú cá nhân hay sổ tay sản phẩm của công ty.
RAG hoạt động thế nào
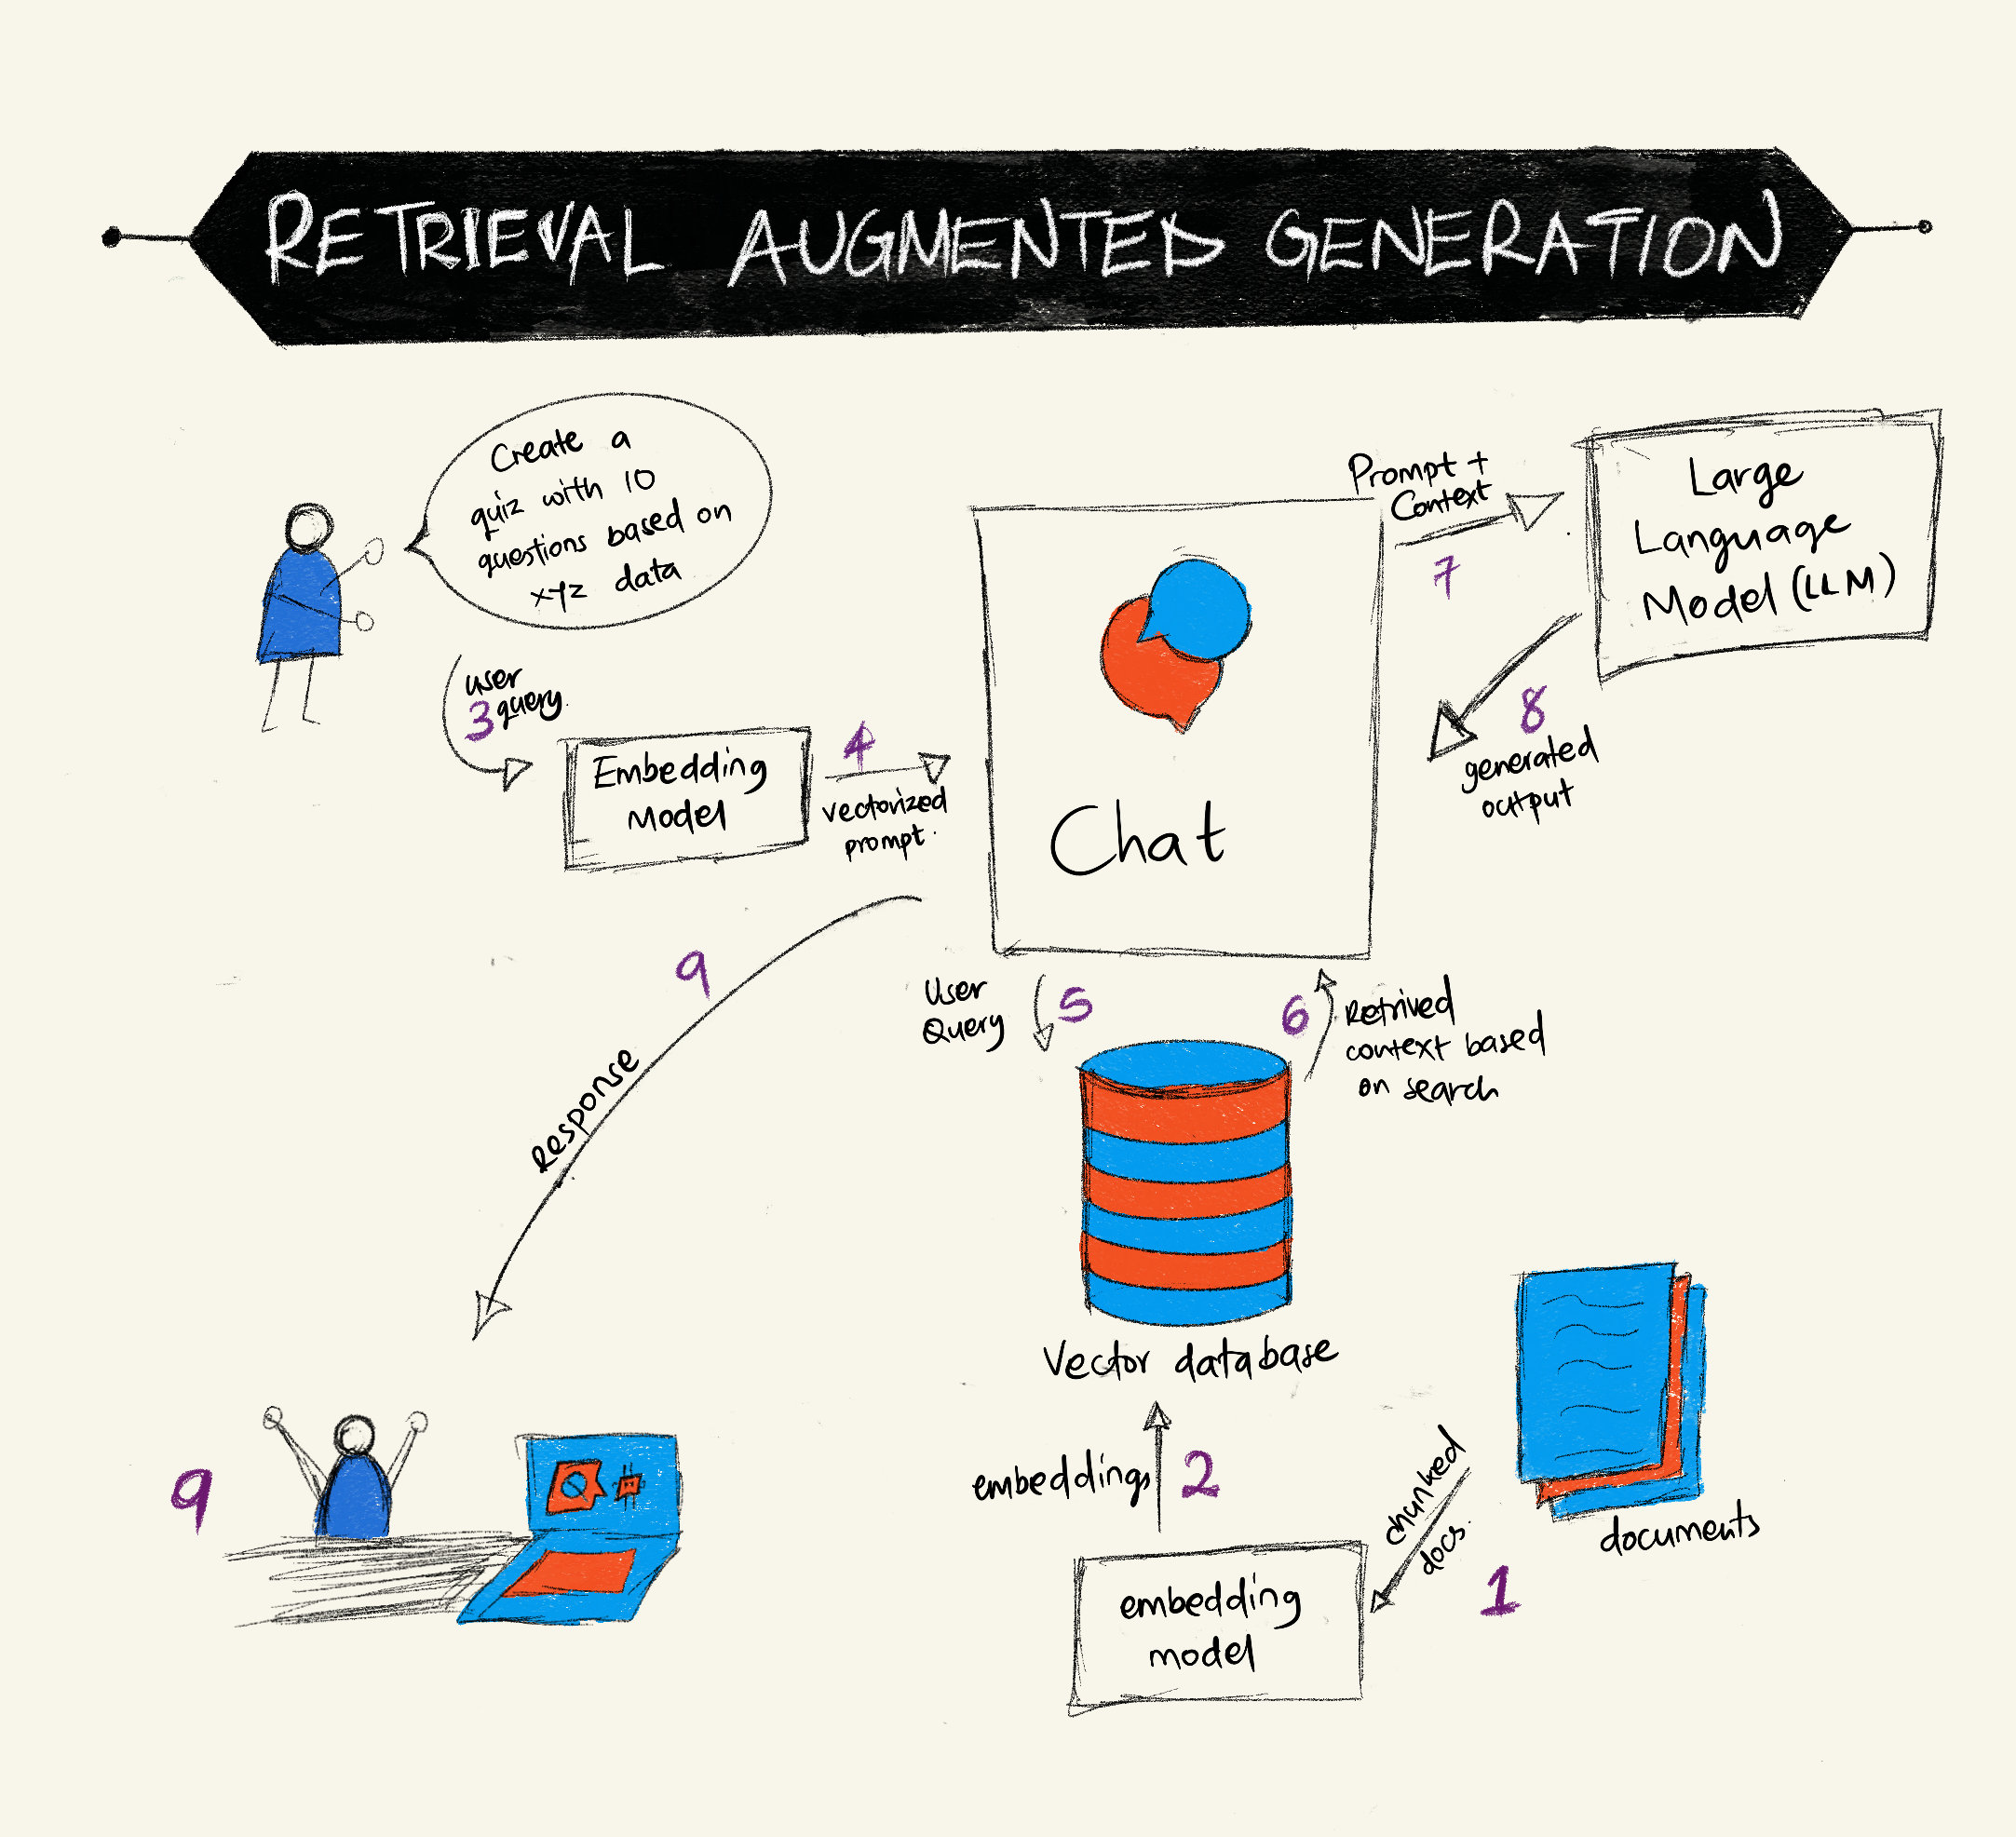
Giả sử bạn muốn triển khai (deploy) một chatbot tạo quiz từ ghi chú của mình, bạn sẽ cần kết nối tới kho tri thức. Đây là lúc Retrieval Augmented Generation (RAG) phát huy tác dụng. RAG hoạt động như sau:
- Kho tri thức (knowledge base): trước khi truy xuất, các tài liệu cần được nạp và tiền xử lý, thường là chia tài liệu lớn thành các đoạn (chunk) nhỏ hơn, chuyển thành text embedding và lưu vào cơ sở dữ liệu.
- Truy vấn của người dùng: người dùng đặt câu hỏi.
- Truy xuất (retrieval): khi người dùng hỏi, model embedding truy xuất thông tin liên quan từ kho tri thức để bổ sung ngữ cảnh vào prompt.
- Sinh có tăng cường (augmented generation): LLM cải thiện câu trả lời dựa trên dữ liệu đã truy xuất. Nhờ đó câu trả lời không chỉ dựa trên dữ liệu huấn luyện sẵn mà còn trên thông tin liên quan từ ngữ cảnh được thêm vào. Dữ liệu truy xuất được dùng để tăng cường câu trả lời, rồi LLM trả lời câu hỏi của người dùng.
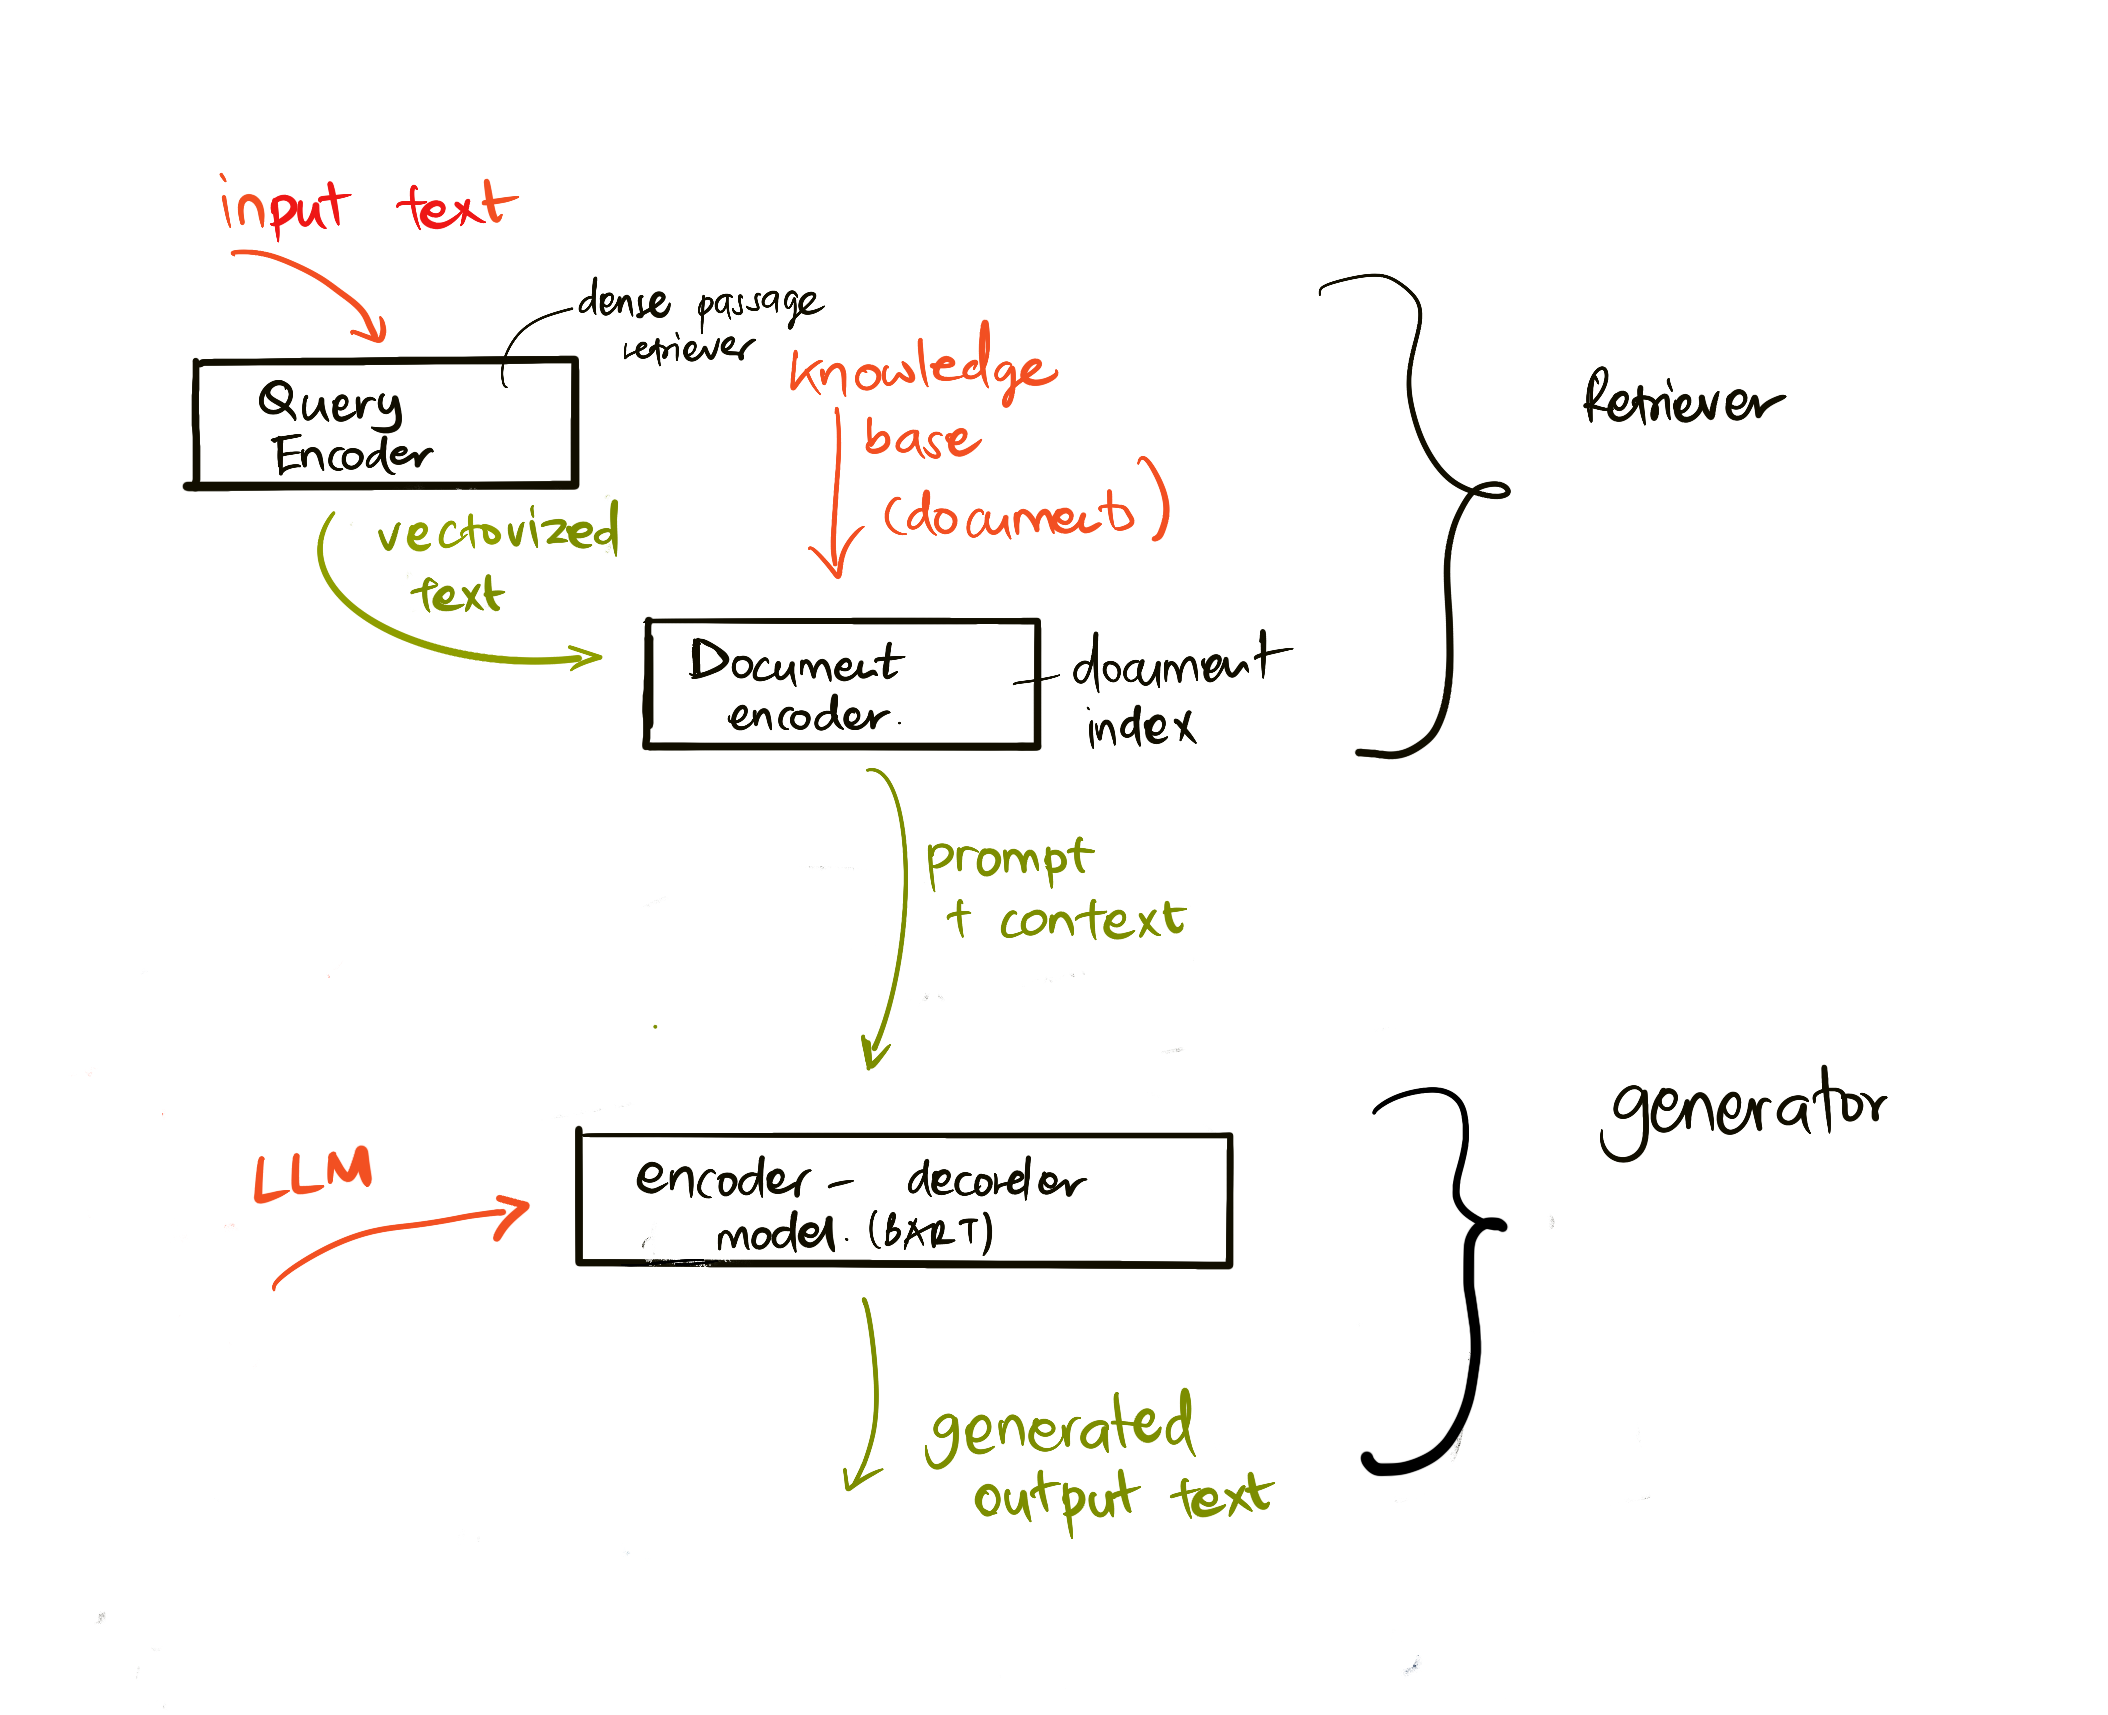
Kiến trúc RAG được cài đặt bằng transformer gồm hai phần: encoder và decoder. Ví dụ, khi người dùng hỏi, văn bản đầu vào được "mã hoá" (encode) thành vector nắm bắt ý nghĩa của từ, rồi các vector được "giải mã" (decode) vào chỉ mục tài liệu và sinh văn bản mới dựa trên truy vấn của người dùng. LLM dùng cả mô hình encoder-decoder để sinh đầu ra.
Theo bài báo đề xuất RAG, Retrieval-Augmented Generation for Knowledge intensive NLP (natural language processing software) Tasks, có hai cách cài đặt:
- RAG-Sequence: dùng các tài liệu truy xuất được để dự đoán câu trả lời tốt nhất cho truy vấn của người dùng.
- RAG-Token: dùng tài liệu để sinh token tiếp theo, rồi truy xuất chúng để trả lời truy vấn của người dùng.
Vì sao dùng RAG?
- Thông tin phong phú: đảm bảo câu trả lời cập nhật, hiện hành. Nhờ truy cập kho tri thức nội bộ, nó cải thiện hiệu năng trên các tác vụ chuyên ngành.
- Giảm nội dung bịa đặt nhờ dùng dữ liệu kiểm chứng được trong kho tri thức để cung cấp ngữ cảnh cho truy vấn.
- Tiết kiệm chi phí, vì rẻ hơn so với fine-tuning một LLM.
Tạo kho tri thức
Ứng dụng của chúng ta dựa trên dữ liệu riêng, tức bài học về mạng nơ-ron trong chương trình AI For Beginners.
Cơ sở dữ liệu vector
Khác với cơ sở dữ liệu truyền thống, cơ sở dữ liệu vector là cơ sở dữ liệu chuyên biệt để lưu, quản lý và tìm kiếm các vector embedding. Nó lưu biểu diễn dạng số của tài liệu. Chia dữ liệu thành các embedding dạng số giúp hệ thống AI dễ hiểu và xử lý dữ liệu hơn.
Chúng ta lưu embedding trong cơ sở dữ liệu vector vì LLM giới hạn số token nhận làm đầu vào. Vì không thể đưa toàn bộ embedding vào LLM, ta cần chia chúng thành các đoạn, và khi người dùng hỏi, các embedding giống câu hỏi nhất sẽ được trả về cùng prompt. Chia đoạn cũng giảm chi phí do số token đi qua LLM ít hơn.
Một số cơ sở dữ liệu vector phổ biến gồm Azure Cosmos DB, Clarifyai, Pinecone, Chromadb, ScaNN, Qdrant và DeepLake. Bạn có thể tạo một Azure Cosmos DB bằng Azure CLI với lệnh sau:
az login
az group create -n <resource-group-name> -l <location>
az cosmosdb create -n <cosmos-db-name> -r <resource-group-name>
az cosmosdb list-keys -n <cosmos-db-name> -g <resource-group-name>
Từ văn bản sang embedding
Trước khi lưu, ta cần chuyển dữ liệu thành vector embedding. Nếu làm việc với tài liệu lớn hoặc văn bản dài, bạn có thể chia đoạn dựa trên các truy vấn dự kiến. Có thể chia theo câu hoặc theo đoạn văn. Vì ý nghĩa của một đoạn phụ thuộc vào các từ xung quanh, bạn có thể thêm ngữ cảnh khác vào đoạn, ví dụ thêm tiêu đề tài liệu hoặc một phần văn bản trước/sau đoạn. Có thể chia đoạn như sau:
def split_text(text, max_length, min_length):
    words = text.split()
    chunks = []
    current_chunk = []

    for word in words:
        current_chunk.append(word)
        if len(' '.join(current_chunk)) < max_length and len(' '.join(current_chunk)) > min_length:
            chunks.append(' '.join(current_chunk))
            current_chunk = []

    # If the last chunk didn't reach the minimum length, add it anyway
    if current_chunk:
        chunks.append(' '.join(current_chunk))

    return chunks
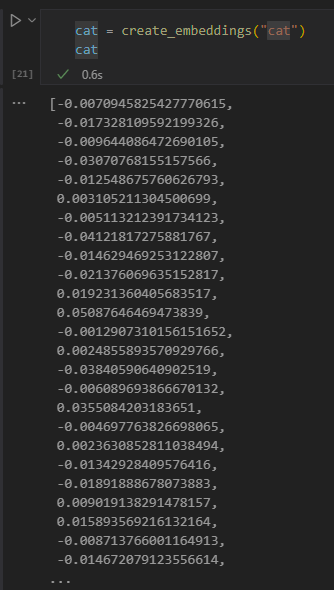
Sau khi chia đoạn, ta embedding văn bản bằng các model embedding khác nhau, như word2vec, ada-002 của OpenAI, Azure Computer Vision và nhiều model khác. Chọn model nào phụ thuộc vào ngôn ngữ bạn dùng, loại nội dung cần mã hoá (văn bản/ảnh/âm thanh), kích thước đầu vào model mã hoá được và độ dài embedding đầu ra.
Ví dụ văn bản được embedding bằng model text-embedding-ada-002 của OpenAI:
Truy xuất và tìm kiếm vector
Khi người dùng hỏi, bộ truy xuất (retriever) chuyển câu hỏi thành vector bằng query encoder, rồi tìm trong chỉ mục tài liệu các vector liên quan tới đầu vào. Xong, nó chuyển cả vector đầu vào lẫn vector tài liệu thành văn bản và đưa qua LLM.
Truy xuất
Truy xuất là khi hệ thống cố tìm nhanh các tài liệu trong chỉ mục thoả tiêu chí tìm kiếm. Mục tiêu của retriever là lấy các tài liệu dùng để cung cấp ngữ cảnh và neo LLM vào dữ liệu của bạn.
Có vài cách tìm kiếm trong cơ sở dữ liệu:
- Tìm kiếm từ khoá (keyword search): dùng cho tìm kiếm văn bản.
- Tìm kiếm vector (vector search): chuyển tài liệu từ văn bản sang biểu diễn vector bằng model embedding, cho phép tìm kiếm ngữ nghĩa dựa trên ý nghĩa của từ. Truy xuất bằng cách lấy các tài liệu có biểu diễn vector gần câu hỏi của người dùng nhất.
- Kết hợp (hybrid): kết hợp cả tìm kiếm từ khoá lẫn tìm kiếm vector.
Một thách thức của truy xuất là khi cơ sở dữ liệu không có câu trả lời nào giống truy vấn, hệ thống vẫn trả về thông tin tốt nhất có được. Bạn có thể dùng các chiến thuật như đặt khoảng cách tối đa để coi là liên quan, hoặc dùng tìm kiếm hybrid. Trong bài này, chúng ta dùng tìm kiếm hybrid, kết hợp tìm kiếm vector và từ khoá. Dữ liệu được lưu trong một dataframe với các cột chứa đoạn văn bản và embedding.
Độ tương đồng vector
Retriever tìm trong kho tri thức các embedding gần nhau, tức láng giềng gần nhất, vì đó là các văn bản tương tự nhau. Khi người dùng hỏi, câu hỏi được embedding trước rồi so khớp với các embedding tương tự. Thước đo phổ biến để xem các vector giống nhau tới đâu là cosine similarity, dựa trên góc giữa hai vector.
Các thước đo thay thế gồm khoảng cách Euclid, tức đường thẳng nối điểm cuối của hai vector, và tích vô hướng (dot product), tức tổng tích các phần tử tương ứng của hai vector.
Chỉ mục tìm kiếm
Khi truy xuất, ta cần dựng chỉ mục tìm kiếm cho kho tri thức trước. Chỉ mục lưu embedding và truy xuất nhanh các đoạn giống nhất, kể cả trong cơ sở dữ liệu lớn. Có thể tạo chỉ mục ở máy local như sau:
from sklearn.neighbors import NearestNeighbors

embeddings = flattened_df['embeddings'].to_list()

# Create the search index
nbrs = NearestNeighbors(n_neighbors=5, algorithm='ball_tree').fit(embeddings)

# To query the index, you can use the kneighbors method
distances, indices = nbrs.kneighbors(embeddings)
Re-ranking
Sau khi truy vấn cơ sở dữ liệu, có thể bạn cần sắp xếp kết quả theo mức liên quan. Một LLM re-ranking dùng machine learning để cải thiện mức liên quan của kết quả tìm kiếm bằng cách sắp xếp từ liên quan nhất. Với Azure AI Search, re-ranking được làm tự động bằng semantic reranker. Ví dụ re-ranking với láng giềng gần nhất:
# Find the most similar documents
distances, indices = nbrs.kneighbors([query_vector])

index = []
# Print the most similar documents
for i in range(3):
    index = indices[0][i]
    for index in indices[0]:
        print(flattened_df['chunks'].iloc[index])
        print(flattened_df['path'].iloc[index])
        print(flattened_df['distances'].iloc[index])
    else:
        print(f"Index {index} not found in DataFrame")
Ghép tất cả lại
Bước cuối là đưa LLM vào để nhận câu trả lời được neo vào dữ liệu của chúng ta:
user_input = "what is a perceptron?"

def chatbot(user_input):
    # Convert the question to a query vector
    query_vector = create_embeddings(user_input)

    # Find the most similar documents
    distances, indices = nbrs.kneighbors([query_vector])

    # add documents to query  to provide context
    history = []
    for index in indices[0]:
        history.append(flattened_df['chunks'].iloc[index])

    # combine the history and the user input
    history.append(user_input)

    # create a message object
    messages=[
        {"role": "system", "content": "You are an AI assistant that helps with AI questions."},
        {"role": "user", "content": "\n\n".join(history) }
    ]

    # use the Responses API to generate a response
    response = client.responses.create(
        model="gpt-5-mini",
        max_output_tokens=800,
        input=messages,
        store=False,
    )

    return response.output_text

chatbot(user_input)
Đánh giá ứng dụng
Các chỉ số đánh giá
- Chất lượng câu trả lời: nghe tự nhiên, trôi chảy, giống người.
- Mức có căn cứ (groundedness) của dữ liệu: câu trả lời có đến từ tài liệu được cung cấp hay không.
- Độ liên quan: câu trả lời có khớp và liên quan tới câu hỏi hay không.
- Độ trôi chảy: câu trả lời có hợp lý về ngữ pháp hay không.
Tình huống dùng RAG và cơ sở dữ liệu vector
Có nhiều tình huống mà function call có thể cải thiện ứng dụng của bạn, như:
- Hỏi đáp: neo dữ liệu công ty vào một chatbot để nhân viên đặt câu hỏi.
- Hệ thống gợi ý: tạo hệ thống so khớp các giá trị giống nhất, như phim, nhà hàng và nhiều thứ khác.
- Dịch vụ chatbot: lưu lịch sử chat và cá nhân hoá hội thoại dựa trên dữ liệu người dùng.
- Tìm kiếm ảnh dựa trên vector embedding, hữu ích cho nhận dạng ảnh và phát hiện bất thường.
Tóm tắt
Chúng ta đã đi qua các phần cơ bản của RAG, từ đưa dữ liệu vào ứng dụng, truy vấn của người dùng tới đầu ra. Để đơn giản hoá việc tạo RAG, bạn có thể dùng các framework như Semantic Kernel, Langchain hoặc Autogen.
Bài tập
Để tiếp tục học về RAG, bạn có thể:
- Xây giao diện front-end cho ứng dụng bằng framework bạn chọn.
- Dùng một framework, LangChain hoặc Semantic Kernel, để dựng lại ứng dụng.
Bài tiếp theo: Model mã nguồn mở.
Nguồn
- Dịch và biên tập từ microsoft/generative-ai-for-beginners · 15-rag-and-vector-databases/README.md, giấy phép MIT.