Bài này đi qua các khái niệm và kỹ thuật thiết yếu để viết prompt hiệu quả cho model AI tạo sinh (generative AI). Cách bạn viết prompt cho LLM rất quan trọng: một prompt được soạn cẩn thận cho câu trả lời chất lượng hơn.
Video bài học (tiếng Anh): xem trên YouTube.
Giới thiệu
Nhưng chính xác thì prompt và prompt engineering nghĩa là gì? Làm sao cải thiện đầu vào prompt gửi tới LLM? Đây là những câu hỏi chúng ta sẽ trả lời trong bài này và bài sau.
AI tạo sinh có thể tạo nội dung mới (văn bản, hình ảnh, âm thanh, code…) theo yêu cầu của người dùng. Nó làm được điều đó nhờ các mô hình ngôn ngữ lớn (LLM) như dòng GPT ("Generative Pre-trained Transformer") của OpenAI, được huấn luyện để dùng ngôn ngữ tự nhiên và code.
Người dùng giờ có thể tương tác với các model này qua những hình thức quen thuộc như chat, không cần chuyên môn kỹ thuật hay đào tạo. Các model này dựa trên prompt: người dùng gửi một đầu vào văn bản (prompt) và nhận lại câu trả lời của AI (completion). Họ có thể "chat với AI" nhiều lượt, chỉnh prompt cho tới khi câu trả lời đúng kỳ vọng.
"Prompt" giờ trở thành giao diện lập trình chính của ứng dụng AI tạo sinh: nó bảo model làm gì và ảnh hưởng tới chất lượng câu trả lời. "Prompt engineering" là lĩnh vực đang phát triển nhanh, tập trung vào thiết kế và tối ưu prompt để có câu trả lời nhất quán, chất lượng ở quy mô lớn.
Mục tiêu học tập
Trong bài này, chúng ta tìm hiểu prompt engineering là gì, vì sao quan trọng và cách soạn prompt hiệu quả hơn cho một model và mục tiêu ứng dụng cụ thể. Kết thúc bài, bạn sẽ có thể:
- Giải thích prompt engineering là gì và vì sao quan trọng.
- Mô tả các thành phần của prompt và cách dùng chúng.
- Nắm các best practice và kỹ thuật prompt engineering.
- Áp dụng các kỹ thuật vào ví dụ thực tế, dùng một endpoint OpenAI.
Thuật ngữ chính
- Prompt engineering: việc thiết kế và tinh chỉnh đầu vào để dẫn model AI tạo ra đầu ra mong muốn.
- Tokenization: quá trình chuyển văn bản thành các đơn vị nhỏ hơn gọi là token, mà model hiểu và xử lý được.
- Instruction-tuned LLM: LLM đã được fine-tuning với các chỉ dẫn cụ thể để câu trả lời chính xác và liên quan hơn.
Học bằng thực hành
Prompt engineering hiện vẫn thiên về nghệ thuật hơn là khoa học. Cách tốt nhất để cải thiện trực giác là thực hành nhiều hơn, thử và sai, kết hợp chuyên môn về lĩnh vực ứng dụng với các kỹ thuật được khuyến nghị và tối ưu riêng cho từng model.
Bài gốc có kèm một Jupyter Notebook làm môi trường "sandbox" để thử những gì bạn học (cần Azure OpenAI API key và Python). Bạn có thể xem notebook trong thư mục bài gốc.
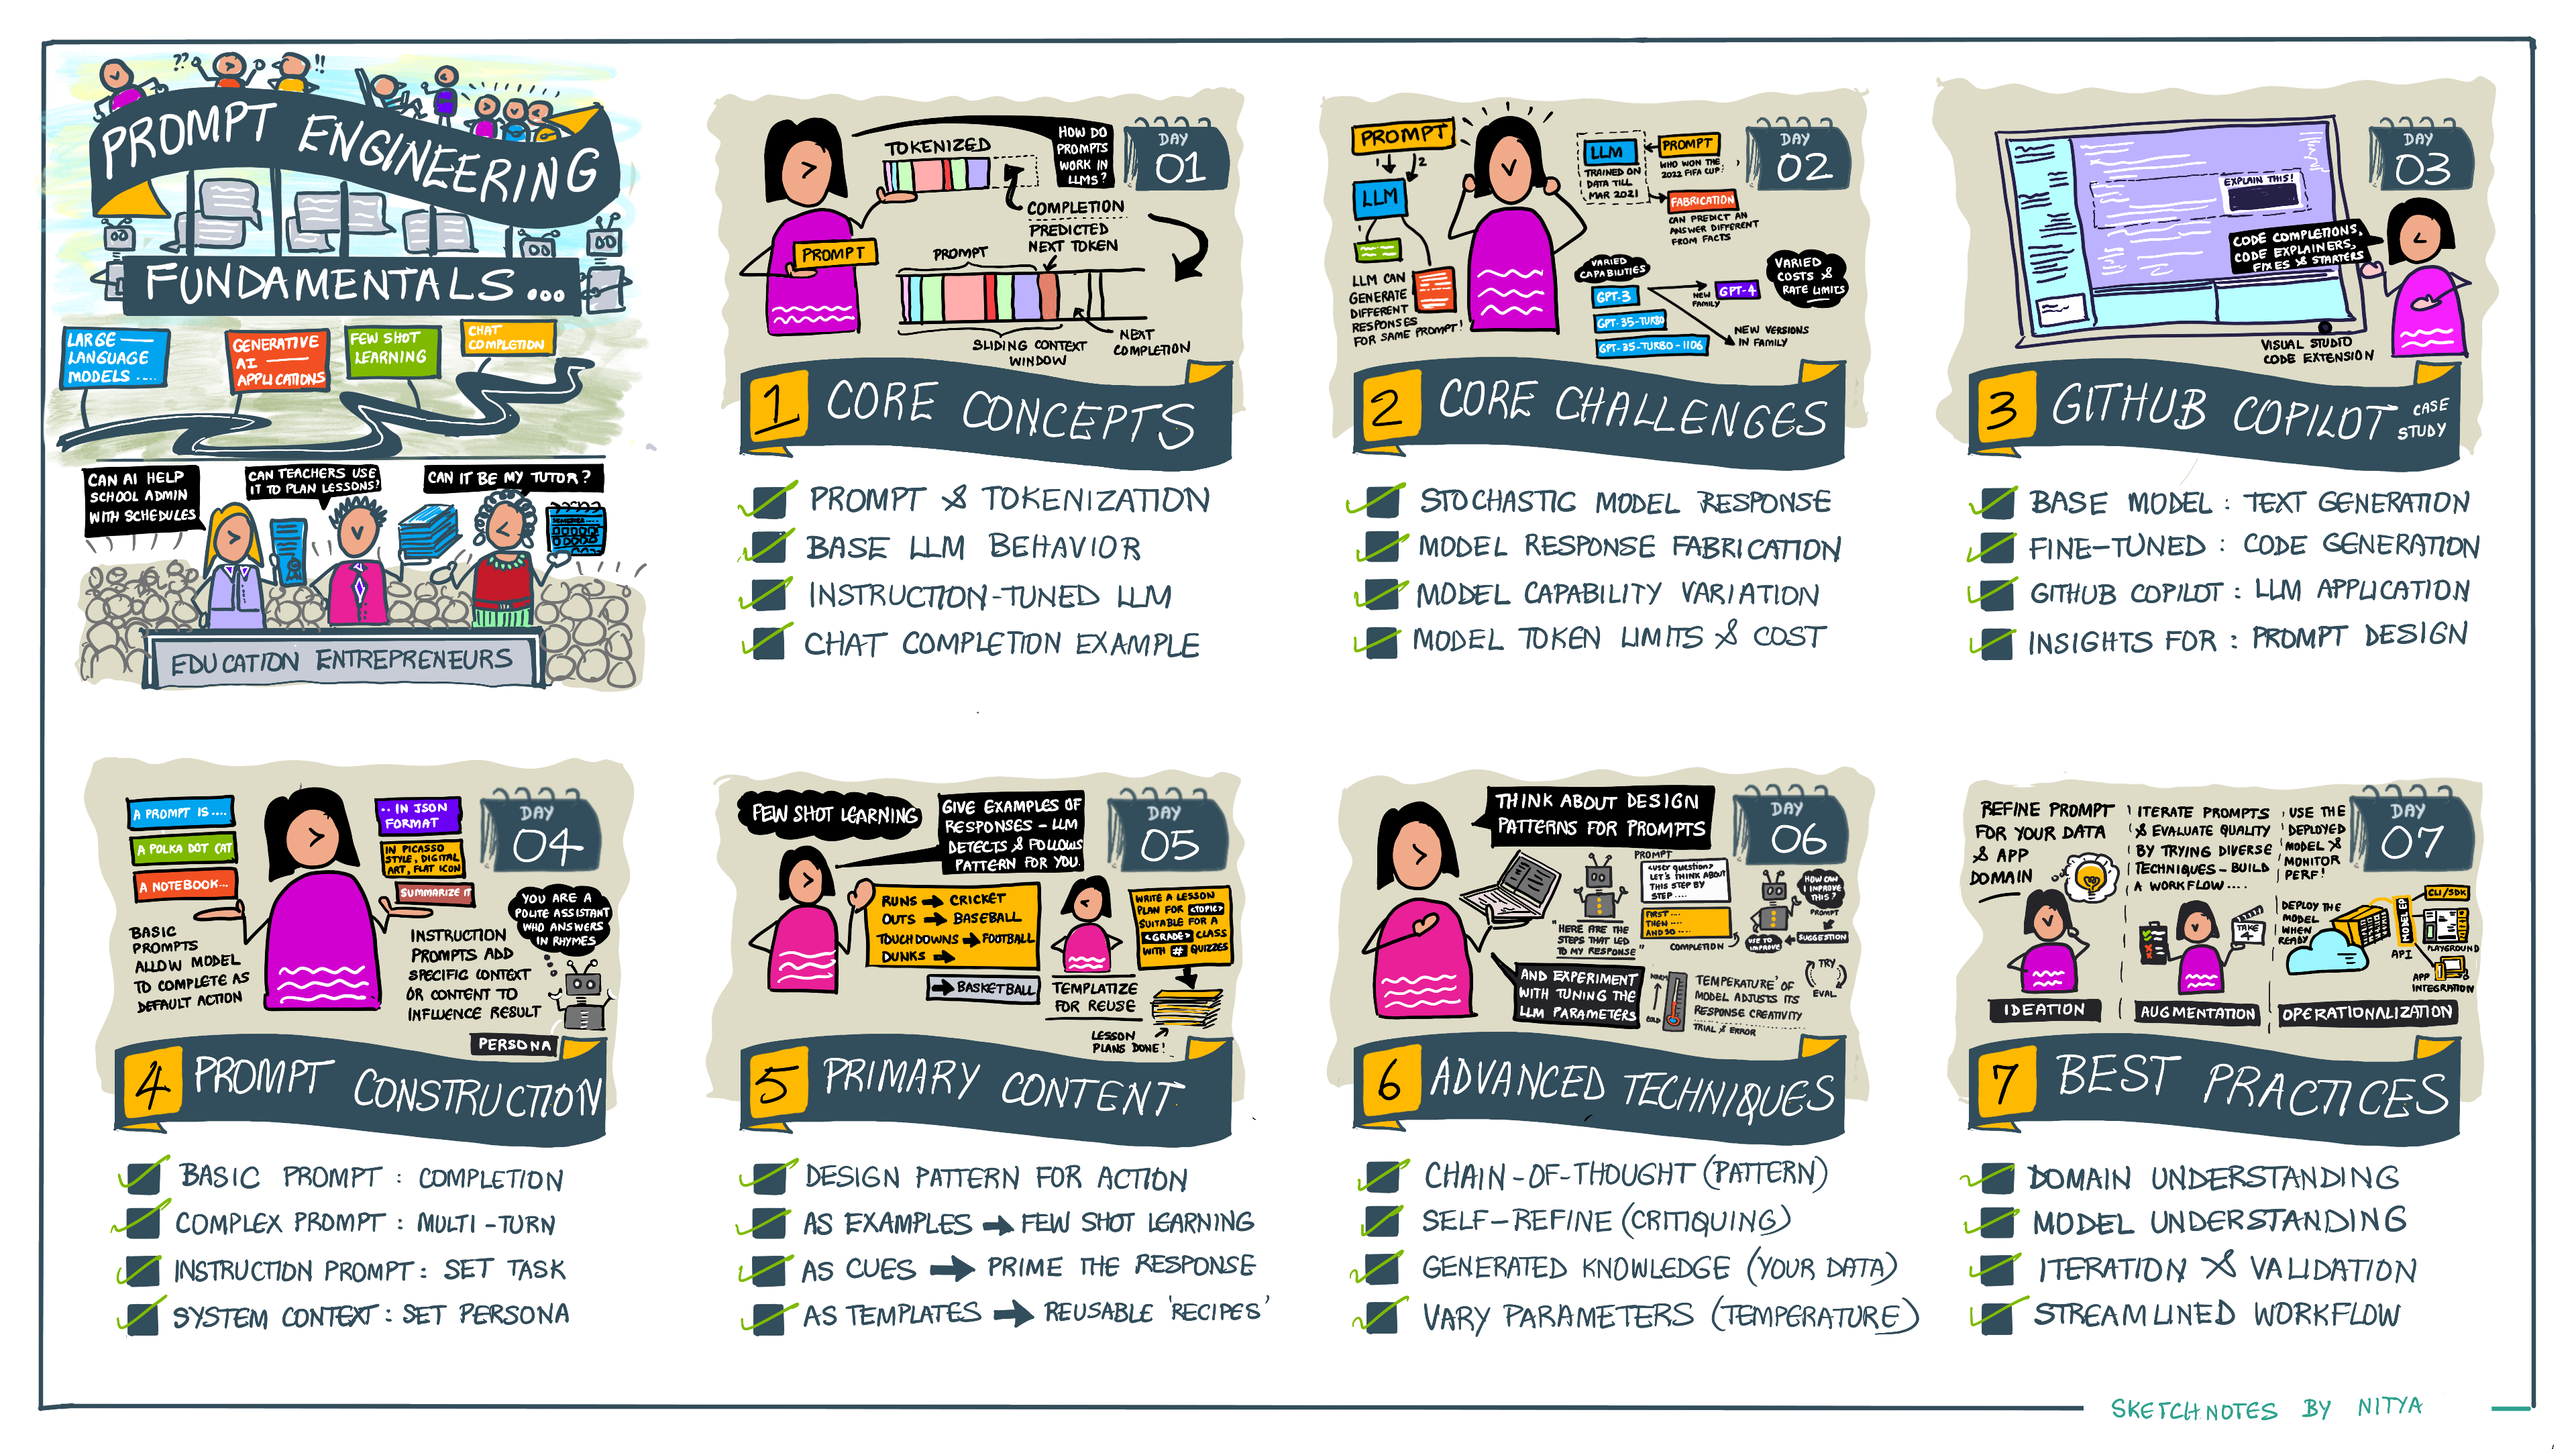
Hình minh hoạ trên tóm tắt lộ trình bài học: từ khái niệm cốt lõi và thách thức tới các kỹ thuật, best practice để giải quyết chúng. Phần "Advanced Techniques" trong hình thuộc về bài sau.
Startup của chúng ta
Chủ đề này liên quan thế nào tới sứ mệnh đưa đổi mới AI vào giáo dục của startup? Chúng ta muốn xây ứng dụng AI cho học tập cá nhân hoá, nên hãy nghĩ xem các nhóm người dùng khác nhau sẽ "thiết kế" prompt ra sao:
- Quản trị viên có thể nhờ AI phân tích dữ liệu chương trình học để tìm phần còn thiếu. AI có thể tóm tắt kết quả hoặc trực quan hoá bằng code.
- Giáo viên có thể nhờ AI soạn giáo án cho một nhóm đối tượng và chủ đề. AI có thể dựng giáo án cá nhân hoá theo định dạng chỉ định.
- Học sinh có thể nhờ AI kèm học một môn khó. AI có thể hướng dẫn bằng bài học, gợi ý và ví dụ phù hợp trình độ.
Đó mới chỉ là phần nổi của tảng băng. Hãy xem Prompts For Education, thư viện prompt mã nguồn mở do chuyên gia giáo dục tuyển chọn, để thấy rộng hơn các khả năng.
Prompt engineering là gì?
Prompt engineering là quá trình thiết kế và tối ưu đầu vào văn bản (prompt) để có câu trả lời (completion) nhất quán, chất lượng cho một mục tiêu ứng dụng và model cụ thể. Có thể xem đây là quy trình 2 bước:
- thiết kế prompt ban đầu cho model và mục tiêu
- tinh chỉnh prompt qua nhiều lần lặp để cải thiện chất lượng câu trả lời
Đây nhất thiết là quá trình thử và sai, cần trực giác và công sức để đạt kết quả tốt nhất. Vậy vì sao nó quan trọng? Để trả lời, trước tiên cần hiểu ba khái niệm:
- Tokenization = model "nhìn" prompt như thế nào
- Base LLM = foundation model "xử lý" prompt như thế nào
- Instruction-tuned LLM = model giờ "nhìn thấy" tác vụ như thế nào
Tokenization
LLM nhìn prompt như một chuỗi token, và các model khác nhau (hoặc các phiên bản của một model) có thể tách token cùng một prompt theo cách khác nhau. Vì LLM được huấn luyện trên token (không phải văn bản thô), cách prompt được tách token ảnh hưởng trực tiếp tới chất lượng câu trả lời.
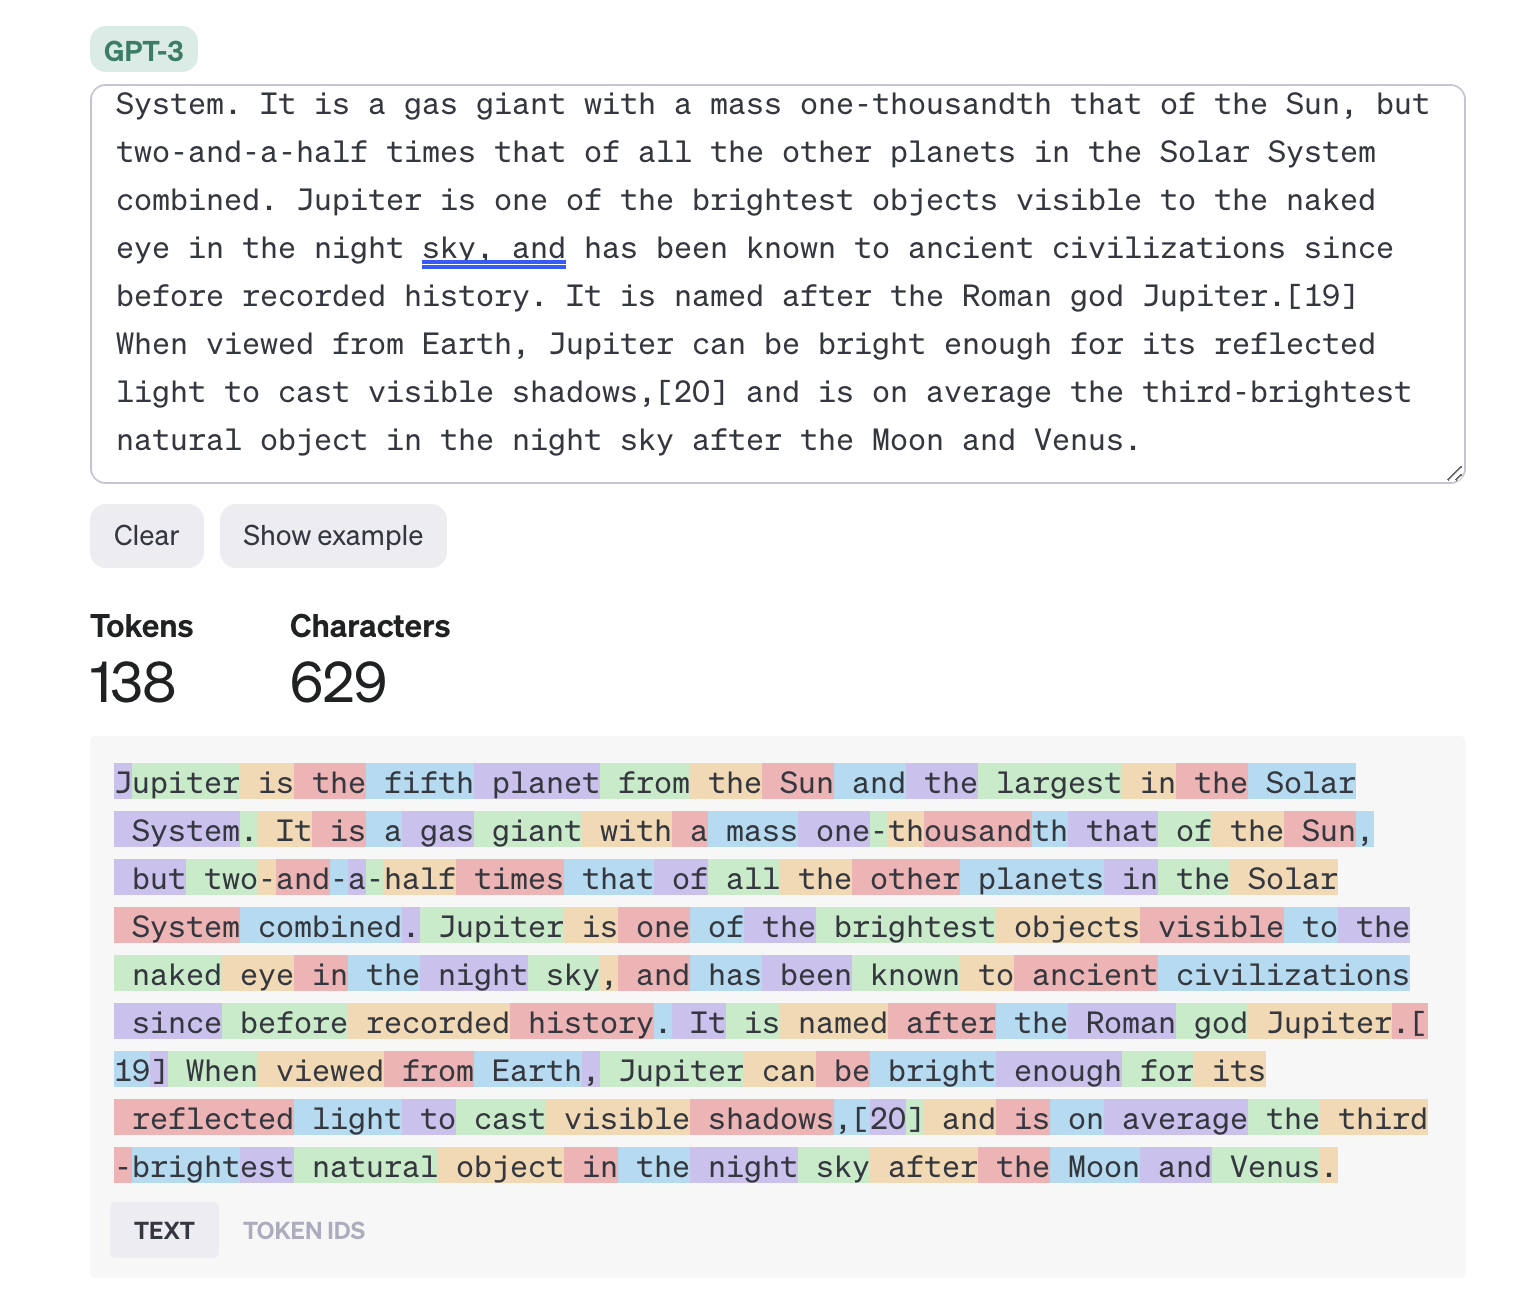
Để hiểu trực quan tokenization, hãy thử công cụ như OpenAI Tokenizer. Dán prompt của bạn vào và xem nó được chuyển thành token ra sao, chú ý cách xử lý khoảng trắng và dấu câu. Ví dụ dưới dùng một LLM cũ (GPT-3), nên thử với model mới hơn có thể cho kết quả khác.
Khái niệm: Foundation Model
Khi prompt đã được tách token, chức năng chính của "Base LLM" (hay foundation model) là dự đoán token tiếp theo trong chuỗi. Vì được huấn luyện trên các tập văn bản khổng lồ, LLM nắm khá tốt quan hệ thống kê giữa các token và dự đoán được với độ tin cậy nhất định. Lưu ý rằng chúng không hiểu ý nghĩa của từ trong prompt hay token; chúng chỉ thấy một khuôn mẫu có thể "hoàn thành" bằng dự đoán tiếp theo. Chúng có thể tiếp tục dự đoán cho tới khi người dùng can thiệp hoặc gặp một điều kiện dừng định sẵn.
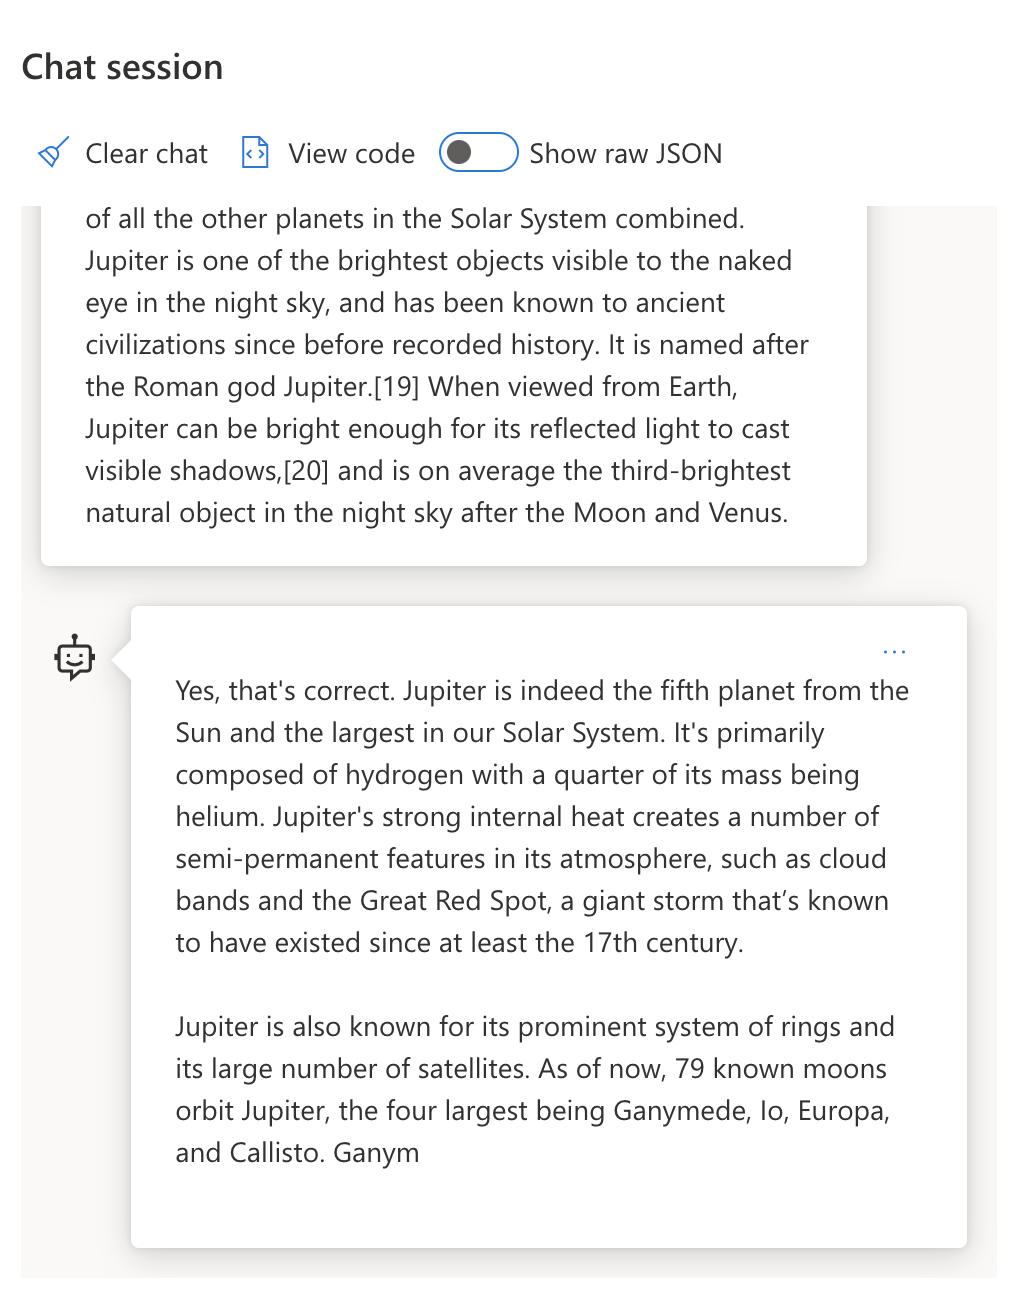
Muốn xem completion dựa trên prompt hoạt động ra sao? Nhập prompt trên vào Microsoft Foundry playground với cấu hình mặc định. Hệ thống được cấu hình để coi prompt là yêu cầu thông tin, nên bạn sẽ thấy một completion đáp ứng ngữ cảnh này.
Nhưng nếu người dùng muốn một kết quả cụ thể thoả tiêu chí hay mục tiêu tác vụ nào đó thì sao? Đây là lúc instruction-tuned LLM xuất hiện.
Khái niệm: Instruction-tuned LLM
Một instruction-tuned LLM bắt đầu từ foundation model rồi fine-tuning bằng ví dụ hoặc cặp đầu vào/đầu ra (như các "message" nhiều lượt) chứa chỉ dẫn rõ ràng, kèm câu trả lời của AI cố gắng làm theo chỉ dẫn đó.
Quá trình này dùng kỹ thuật như Reinforcement Learning with Human Feedback (RLHF) để huấn luyện model làm theo chỉ dẫn và học từ phản hồi, nhờ đó câu trả lời phù hợp hơn với ứng dụng thực tế và sát mục tiêu người dùng hơn.
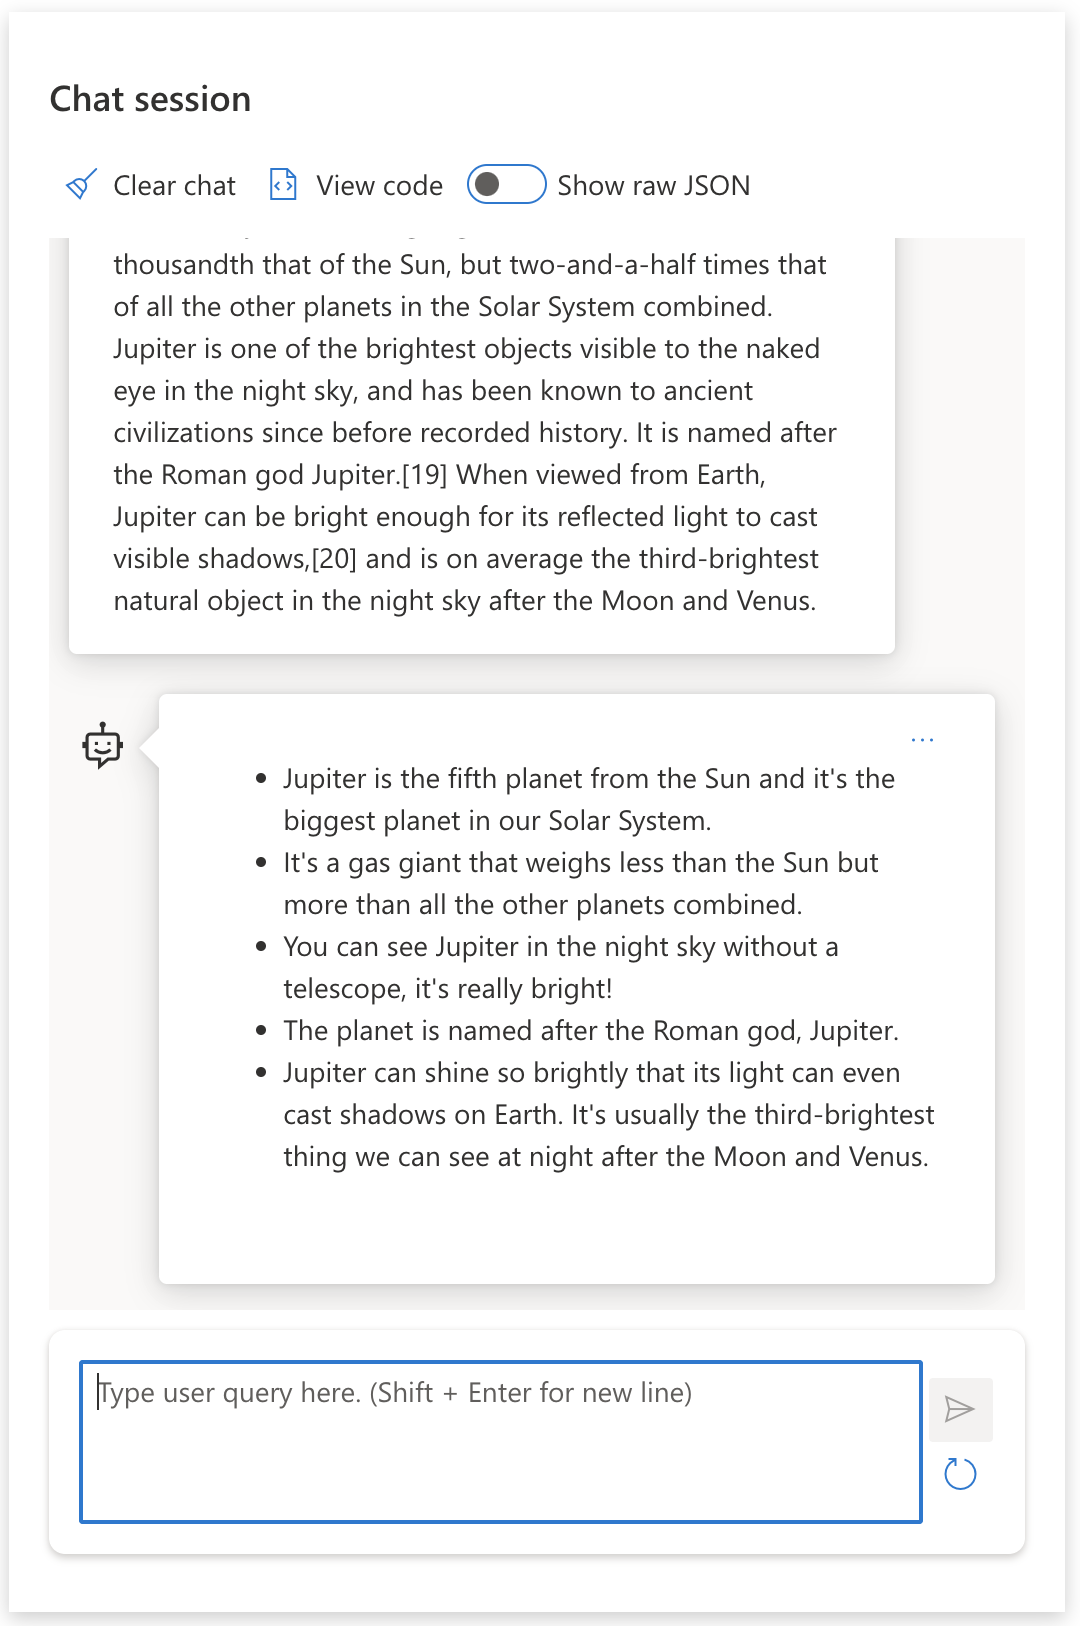
Hãy thử: quay lại prompt trên, nhưng giờ đổi system message thành chỉ dẫn sau làm ngữ cảnh:
Summarize content you are provided with for a second-grade student. Keep the result to one paragraph with 3-5 bullet points.
(Tóm tắt nội dung được cung cấp cho học sinh lớp 2, gói trong một đoạn với 3-5 gạch đầu dòng.) Bạn thấy kết quả giờ đã được điều chỉnh theo mục tiêu và định dạng mong muốn chưa? Giáo viên có thể dùng ngay câu trả lời này trong slide cho lớp học.
Vì sao cần prompt engineering?
Giờ đã biết LLM xử lý prompt ra sao, hãy nói về lý do cần prompt engineering. Câu trả lời nằm ở chỗ LLM hiện nay có một số thách thức khiến việc có completion đáng tin và nhất quán khó hơn nếu không đầu tư vào xây dựng và tối ưu prompt. Ví dụ:
- Câu trả lời của model mang tính ngẫu nhiên. Cùng một prompt nhiều khả năng cho câu trả lời khác nhau với các model hoặc phiên bản model khác nhau, thậm chí với cùng model ở các thời điểm khác nhau. Kỹ thuật prompt engineering giúp giảm các biến động này bằng cách đặt "rào chắn" tốt hơn.
- Model có thể bịa câu trả lời. Model được huấn luyện trước trên tập dữ liệu lớn nhưng hữu hạn, nên thiếu kiến thức về những khái niệm ngoài phạm vi đó. Vì vậy chúng có thể tạo completion không chính xác, tưởng tượng, hoặc mâu thuẫn trực tiếp với sự thật đã biết. Kỹ thuật prompt engineering giúp người dùng nhận ra và giảm các nội dung bịa đặt, ví dụ bằng cách yêu cầu AI đưa trích dẫn hoặc lập luận.
- Khả năng của model khác nhau. Model hoặc thế hệ model mới có khả năng phong phú hơn nhưng cũng có những điểm riêng và đánh đổi về chi phí, độ phức tạp. Prompt engineering giúp xây dựng best practice và quy trình (workflow) che đi các khác biệt và thích ứng với yêu cầu riêng của từng model một cách liền mạch, mở rộng được.
Hãy thử trong OpenAI hoặc Azure OpenAI Playground:
- Dùng cùng một prompt với các bản triển khai LLM khác nhau (OpenAI, Azure OpenAI, Hugging Face): bạn có thấy khác biệt không?
- Dùng cùng một prompt nhiều lần với cùng bản triển khai LLM (ví dụ Azure OpenAI playground): các khác biệt này thế nào?
Ví dụ về nội dung bịa đặt
Trong khoá học này, chúng ta dùng thuật ngữ "bịa đặt" (fabrication) để chỉ hiện tượng LLM đôi khi tạo thông tin sai sự thật do giới hạn trong huấn luyện hoặc các ràng buộc khác. Có thể bạn đã nghe gọi là "ảo giác" (hallucination) trong các bài báo hay nghiên cứu. Tuy nhiên, khoá học khuyến nghị dùng "fabrication" để tránh vô tình nhân cách hoá hành vi này, tức gán đặc điểm giống con người cho một kết quả do máy tạo ra. Điều này cũng củng cố hướng dẫn AI có trách nhiệm về mặt thuật ngữ, loại bỏ những từ có thể bị coi là xúc phạm hoặc thiếu hoà nhập trong một số bối cảnh.
Muốn hiểu nội dung bịa đặt hình thành thế nào? Hãy nghĩ một prompt yêu cầu AI tạo nội dung về một chủ đề không tồn tại (để chắc nó không có trong dữ liệu huấn luyện). Ví dụ, tác giả đã thử prompt này:
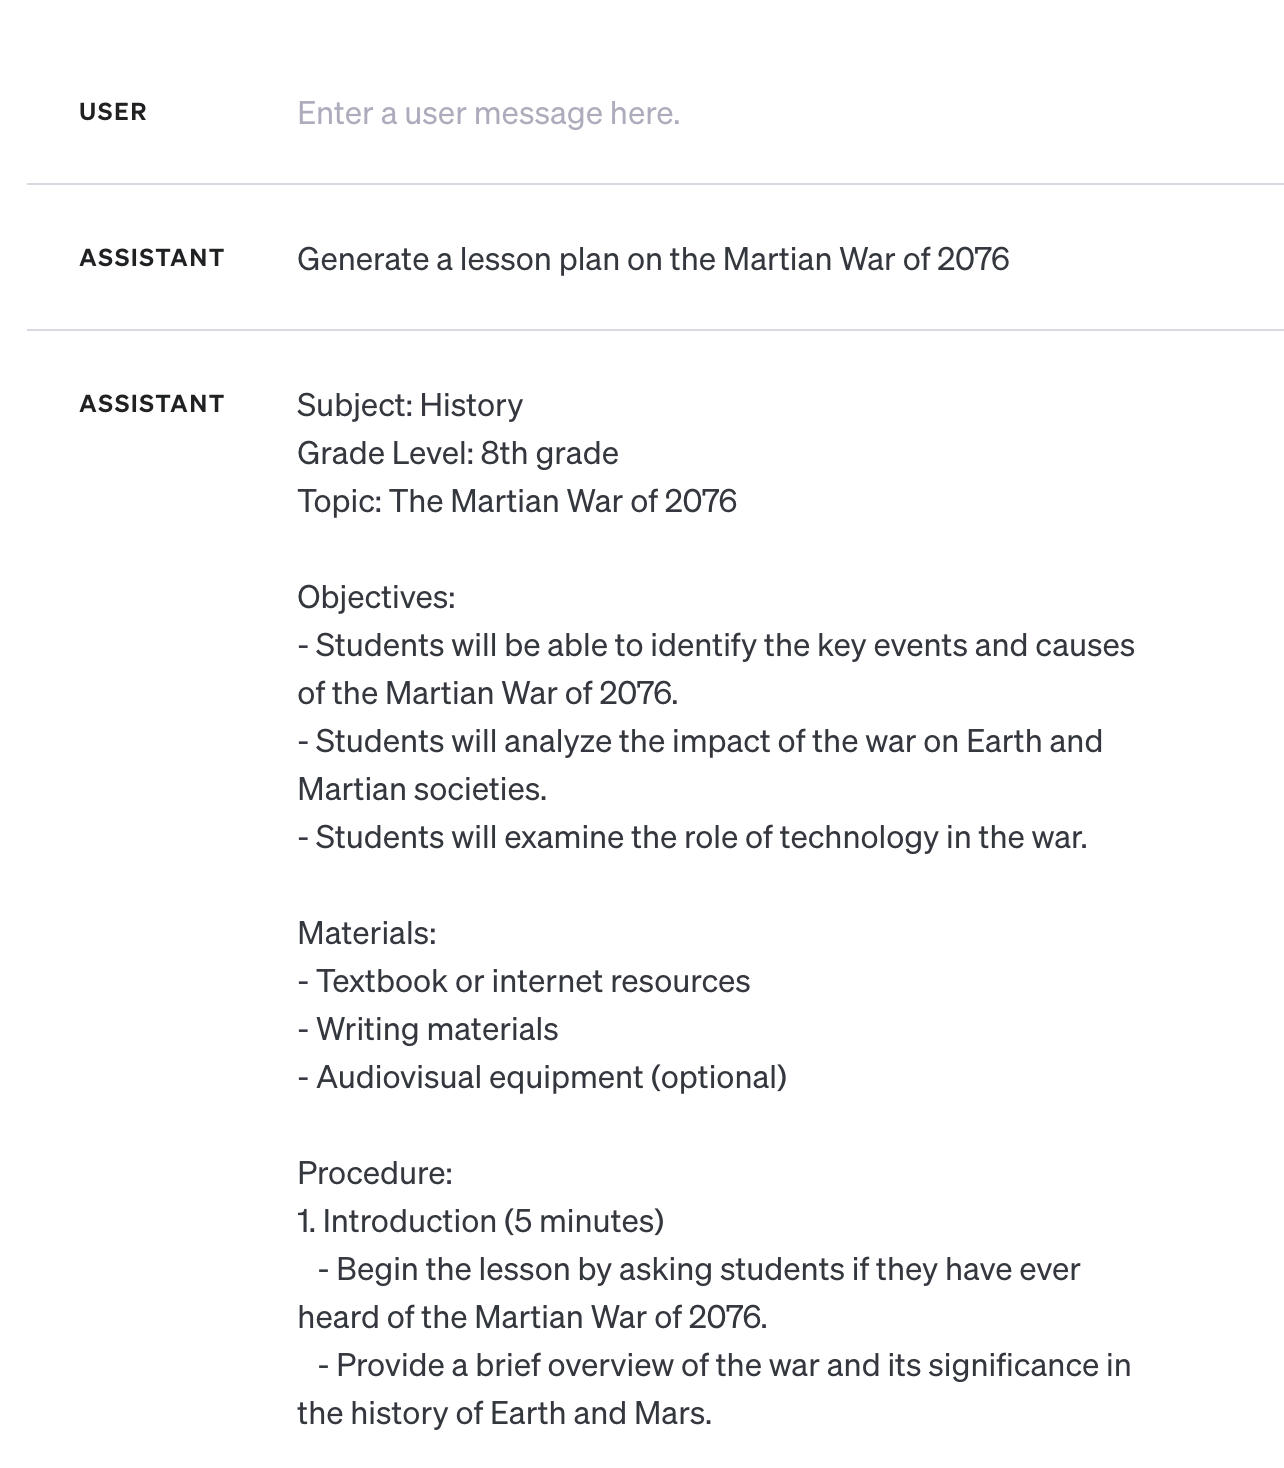
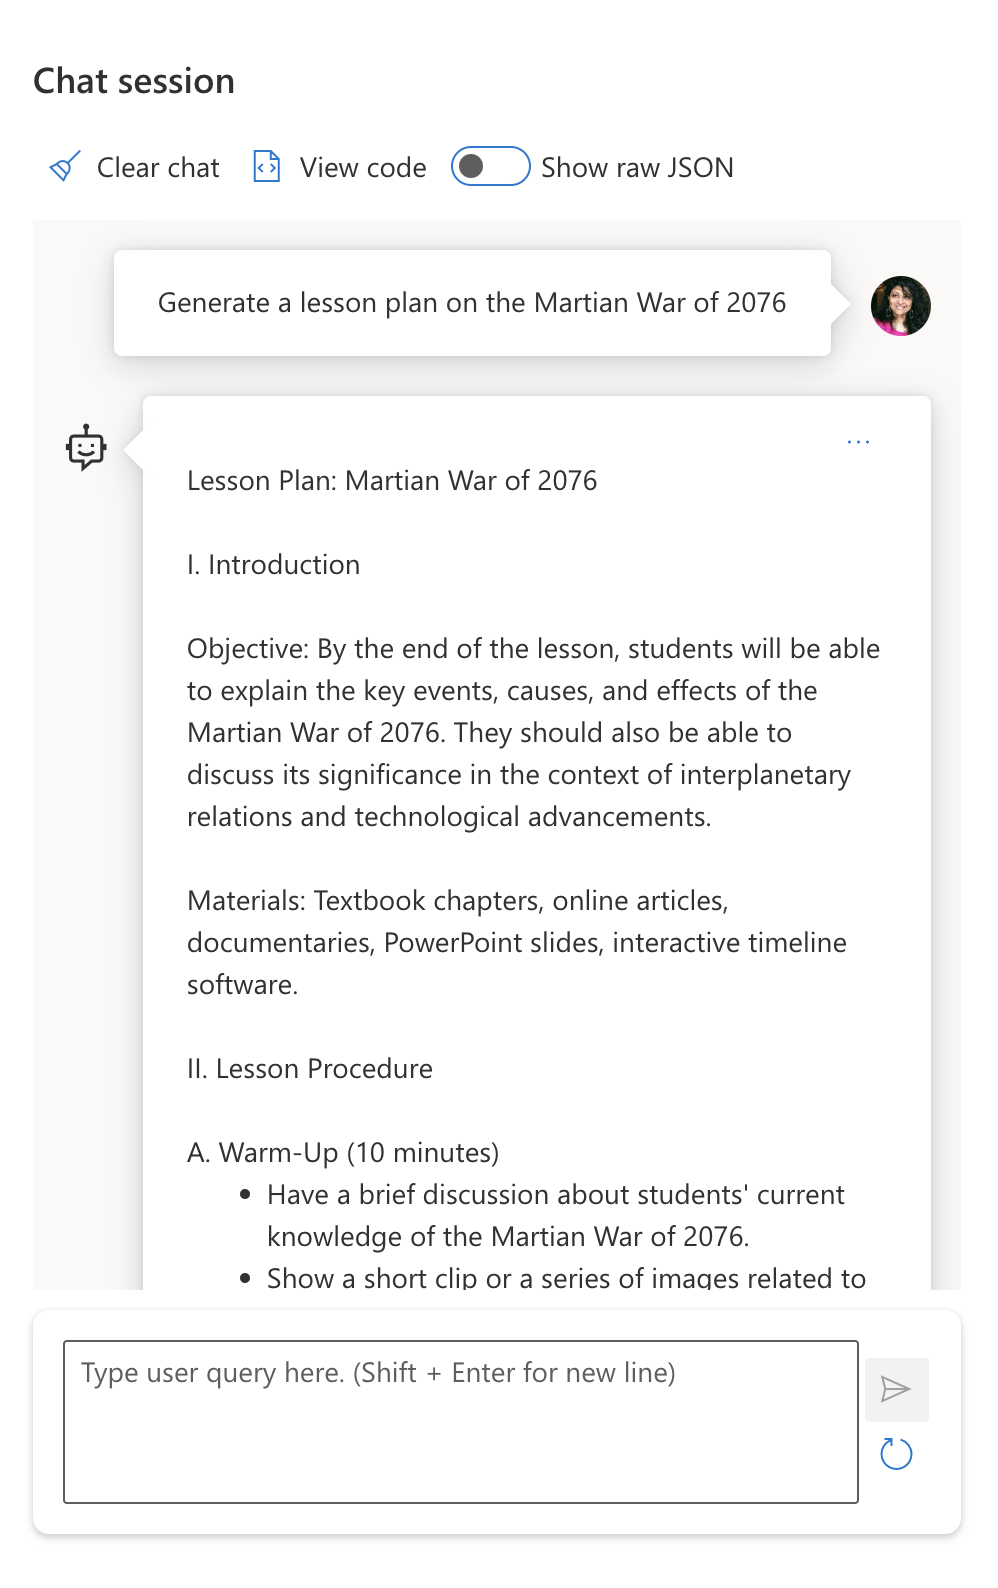
Prompt: generate a lesson plan on the Martian War of 2076.
Tìm trên web cho thấy có những câu chuyện hư cấu (phim truyền hình, sách) về chiến tranh trên sao Hoả, nhưng không có cuộc chiến nào năm 2076. Lẽ thường cũng cho biết 2076 là tương lai, nên không thể gắn với một sự kiện có thật.
Vậy điều gì xảy ra khi chạy prompt này với các nhà cung cấp LLM khác nhau?
Câu trả lời 1: OpenAI Playground (GPT-35)
Câu trả lời 2: Azure OpenAI Playground (GPT-35)
Câu trả lời 3: Hugging Face Chat Playground (LLama-2)
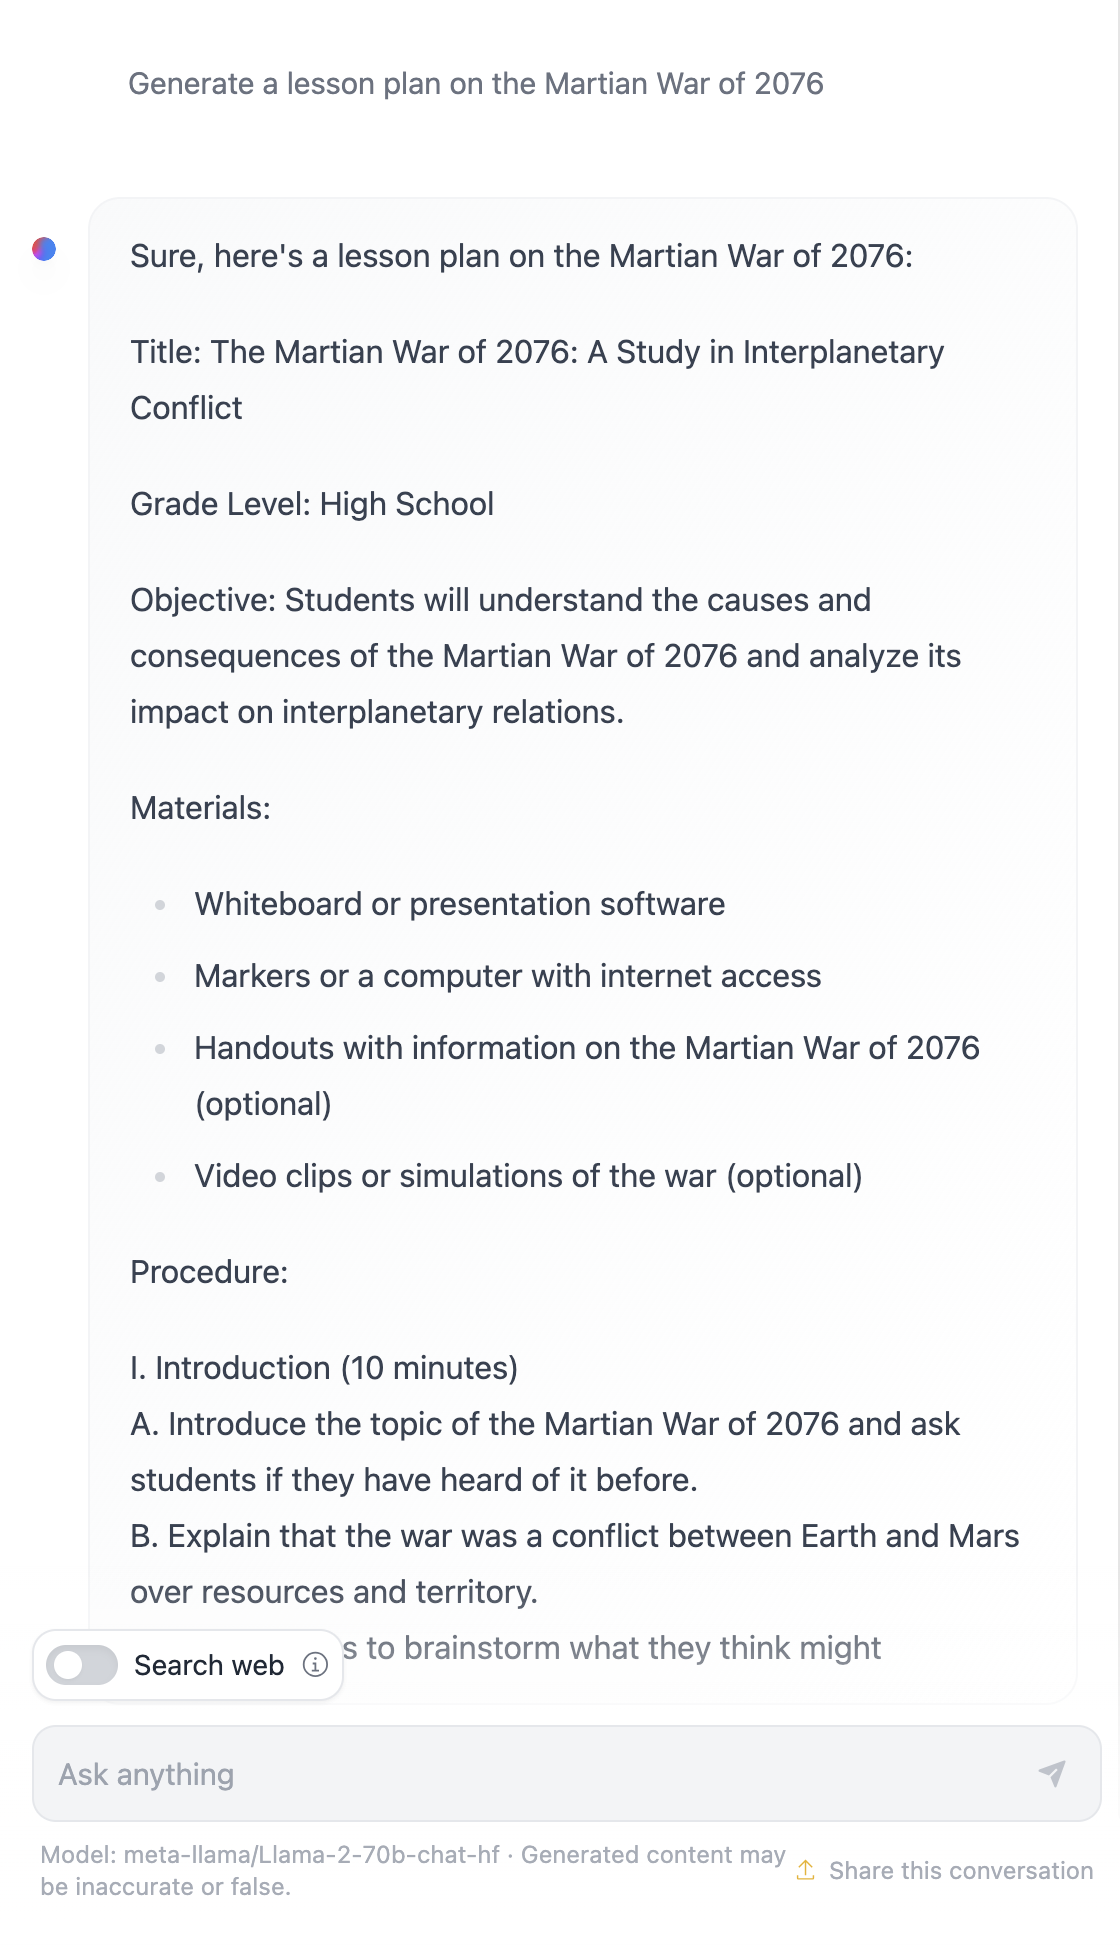
Như dự đoán, mỗi model (hoặc phiên bản model) cho câu trả lời hơi khác nhau, do tính ngẫu nhiên và khác biệt về khả năng. Ví dụ, một model nhắm tới học sinh lớp 8, model khác lại giả định người học là học sinh trung học phổ thông. Nhưng cả ba model đều tạo câu trả lời đủ để thuyết phục một người dùng thiếu thông tin rằng sự kiện là có thật.
Các kỹ thuật prompt engineering như metaprompting và cấu hình temperature có thể giảm phần nào nội dung bịa đặt. Các kiến trúc prompt engineering mới cũng đưa thêm công cụ và kỹ thuật vào luồng prompt một cách liền mạch để giảm bớt những hiệu ứng này.
Tình huống thực tế: GitHub Copilot
Hãy kết thúc phần này bằng một tình huống thực tế về cách prompt engineering được dùng trong giải pháp thật: GitHub Copilot.
GitHub Copilot là "lập trình viên AI cặp đôi" của bạn: nó chuyển prompt văn bản thành code completion và được tích hợp vào môi trường phát triển (như Visual Studio Code) để trải nghiệm liền mạch. Theo loạt bài blog dưới đây, phiên bản đầu tiên dựa trên model OpenAI Codex, và các kỹ sư nhanh chóng nhận ra cần fine-tuning model và phát triển kỹ thuật prompt engineering tốt hơn để cải thiện chất lượng code. Vào tháng 7, họ ra mắt một model AI cải tiến vượt qua Codex cho gợi ý nhanh hơn nữa.
Đọc các bài theo thứ tự để theo dõi hành trình của họ:
- 05/2023 | GitHub Copilot is Getting Better at Understanding Your Code
- 05/2023 | Inside GitHub: Working with the LLMs behind GitHub Copilot
- 06/2023 | How to write better prompts for GitHub Copilot
- 07/2023 | .. GitHub Copilot goes beyond Codex with improved AI model
- 07/2023 | A Developer's Guide to Prompt Engineering and LLMs
- 09/2023 | How to build an enterprise LLM app: Lessons from GitHub Copilot
Bạn cũng có thể xem Engineering blog của họ để đọc thêm các bài như bài này, cho thấy các model và kỹ thuật này được áp dụng vào ứng dụng thực tế.
Cấu trúc prompt
Đã thấy vì sao prompt engineering quan trọng, giờ hãy xem prompt được cấu trúc ra sao để đánh giá các kỹ thuật thiết kế prompt hiệu quả hơn.
Prompt cơ bản
Bắt đầu với prompt cơ bản: một đầu vào văn bản gửi tới model, không có ngữ cảnh nào khác. Ví dụ, khi gửi vài từ đầu của quốc ca Mỹ tới Completion API của OpenAI, nó lập tức hoàn thành câu trả lời với vài dòng tiếp theo, minh hoạ hành vi dự đoán cơ bản.
| Prompt (đầu vào) | Completion (đầu ra) |
|---|---|
| Oh say can you see | It sounds like you're starting the lyrics to "The Star-Spangled Banner," the national anthem of the United States. The full lyrics are ... |
Prompt phức tạp
Giờ hãy thêm ngữ cảnh và chỉ dẫn vào prompt cơ bản đó. Chat Completion API cho phép dựng prompt phức tạp dưới dạng một tập message gồm:
- Các cặp đầu vào/đầu ra phản ánh đầu vào của user và câu trả lời của assistant.
- System message đặt ngữ cảnh cho hành vi hoặc tính cách của assistant.
Yêu cầu giờ có dạng như dưới, trong đó tokenization nắm được thông tin liên quan từ ngữ cảnh và cuộc hội thoại. Lúc này, thay đổi ngữ cảnh hệ thống có thể ảnh hưởng tới chất lượng completion không kém gì đầu vào của người dùng.
response = client.responses.create(
    model="gpt-5-mini",
    input=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Who won the world series in 2020?"},
        {"role": "assistant", "content": "The Los Angeles Dodgers won the World Series in 2020."},
        {"role": "user", "content": "Where was it played?"}
    ]
)
Prompt chỉ dẫn
Ở các ví dụ trên, prompt của người dùng là một truy vấn văn bản đơn giản, có thể hiểu là yêu cầu thông tin. Với prompt chỉ dẫn (instruction), ta dùng văn bản đó để mô tả tác vụ chi tiết hơn, hướng dẫn AI tốt hơn. Ví dụ:
| Prompt (đầu vào) | Completion (đầu ra) | Loại chỉ dẫn |
|---|---|---|
| Write a description of the Civil War | trả về một đoạn văn đơn giản | Đơn giản |
| Write a description of the Civil War. Provide key dates and events and describe their significance | trả về một đoạn văn, tiếp theo là danh sách các mốc sự kiện chính kèm mô tả | Phức tạp |
| Write a description of the Civil War in 1 paragraph. Provide 3 bullet points with key dates and their significance. Provide 3 more bullet points with key historical figures and their contributions. Return the output as a JSON file | trả về chi tiết hơn trong một khung văn bản, định dạng JSON để bạn sao chép vào file và kiểm tra khi cần | Phức tạp, có định dạng |
Nội dung chính (primary content)
Ở các ví dụ trên, prompt vẫn khá mở, để LLM tự quyết phần nào trong dữ liệu đã học là liên quan. Với mẫu thiết kế nội dung chính (primary content), văn bản đầu vào chia làm hai phần:
- một chỉ dẫn (hành động)
- nội dung liên quan (ảnh hưởng tới hành động)
Ví dụ dưới đây có chỉ dẫn là "summarize this in 2 sentences" (tóm tắt trong 2 câu).
Prompt (đầu vào):
Jupiter is the fifth planet from the Sun and the largest in the Solar System. It is a gas giant with a mass one-thousandth that of the Sun, but two-and-a-half times that of all the other planets in the Solar System combined. Jupiter is one of the brightest objects visible to the naked eye in the night sky, and has been known to ancient civilizations since before recorded history. It is named after the Roman god Jupiter.[19] When viewed from Earth, Jupiter can be bright enough for its reflected light to cast visible shadows,[20] and is on average the third-brightest natural object in the night sky after the Moon and Venus.
Summarize this in 2 short sentences
Completion (đầu ra):
Jupiter, the fifth planet from the Sun, is the largest in the Solar System and is known for being one of the brightest objects in the night sky. Named after the Roman god Jupiter, it's a gas giant whose mass is two-and-a-half times that of all other planets in the Solar System combined.
Phần nội dung chính có thể dùng theo nhiều cách để chỉ dẫn hiệu quả hơn:
- Ví dụ (examples): thay vì bảo model làm gì bằng chỉ dẫn tường minh, hãy đưa ví dụ về việc cần làm và để model tự suy ra khuôn mẫu.
- Gợi mở (cues): sau chỉ dẫn, thêm một "cue" mồi cho completion, dẫn model tới câu trả lời liên quan hơn.
- Mẫu (templates): các "công thức" prompt dùng lại được, có chỗ trống (biến) để điền dữ liệu cho từng tình huống.
Hãy xem từng cách hoạt động ra sao.
Dùng ví dụ
Cách này dùng nội dung chính để "cho model ăn" vài ví dụ về đầu ra mong muốn cho một chỉ dẫn, rồi để model suy ra khuôn mẫu. Tuỳ số ví dụ, ta có zero-shot, one-shot, few-shot prompting…
Prompt giờ gồm ba thành phần:
- Mô tả tác vụ
- Vài ví dụ về đầu ra mong muốn
- Phần đầu của một ví dụ mới (trở thành mô tả tác vụ ngầm)
Zero-shot, prompt:
"The Sun is Shining". Translate to Spanish
Completion: "El Sol está brillando".
One-shot, prompt:
"The Sun is Shining" => ""El Sol está brillando".
"It's a Cold and Windy Day" =>
Completion: "Es un día frío y ventoso".
Few-shot, prompt:
The player ran the bases => Baseball
The player hit an ace => Tennis
The player hit a six => Cricket
The player made a slam-dunk =>
Completion: Basketball
Để ý rằng với zero-shot, ta phải đưa chỉ dẫn tường minh ("Translate to Spanish"), còn ở one-shot thì chỉ dẫn được suy ra. Ví dụ few-shot cho thấy thêm nhiều ví dụ giúp model suy luận chính xác hơn mà không cần thêm chỉ dẫn.
Gợi mở trong prompt (prompt cues)
Một kỹ thuật khác với nội dung chính là đưa cue thay vì ví dụ. Lúc này ta "đẩy nhẹ" model đúng hướng bằng cách mở đầu bằng một đoạn phản ánh định dạng câu trả lời mong muốn. Model sẽ "bắt cue" và viết tiếp theo hướng đó. Cả ba ví dụ dưới dùng cùng đoạn văn về sao Mộc, theo sau là chỉ dẫn Summarize This; chỉ khác ở phần cue thêm vào cuối prompt.
| Số cue | Phần cuối prompt | Completion (đầu ra) |
|---|---|---|
| 0 | Summarize This | Jupiter is the largest planet in our Solar System and the fifth one from the Sun. It is a gas giant with a mass 1/1000th of the Sun's, but it is heavier than all the other planets combined. Ancient civilizations have known about Jupiter for a long time, and it is easily visible in the night sky.. |
| 1 | Summarize This rồi What we learned is that Jupiter | is the fifth planet from the Sun and the largest in the Solar System. It is a gas giant with a mass one-thousandth that of the Sun, but two-and-a-half times that of all the other planets combined. It is easily visible to the naked eye and has been known since ancient times. |
| 2 | Summarize This rồi Top 3 Facts We Learned: | 1. Jupiter is the fifth planet from the Sun and the largest in the Solar System. 2. It is a gas giant with a mass one-thousandth that of the Sun... 3. Jupiter has been visible to the naked eye since ancient times ... |
Mẫu prompt (prompt templates)
Mẫu prompt là một công thức prompt định sẵn, có thể lưu và dùng lại khi cần, giúp trải nghiệm người dùng nhất quán ở quy mô lớn. Ở dạng đơn giản nhất, nó chỉ là một tập ví dụ prompt như ví dụ này của OpenAI, cung cấp cả các thành phần prompt tương tác (user và system message) lẫn định dạng request qua API để dùng lại.
Ở dạng phức tạp hơn, như ví dụ này của LangChain, mẫu chứa các chỗ trống (placeholder) có thể thay bằng dữ liệu từ nhiều nguồn (đầu vào người dùng, ngữ cảnh hệ thống, nguồn dữ liệu ngoài…) để sinh prompt động. Nhờ vậy ta tạo được thư viện prompt dùng lại, giúp trải nghiệm nhất quán bằng lập trình ở quy mô lớn.
Cuối cùng, giá trị thật của mẫu nằm ở khả năng tạo và xuất bản thư viện prompt cho từng lĩnh vực ứng dụng, nơi mẫu prompt được tối ưu theo ngữ cảnh hoặc ví dụ riêng của ứng dụng, giúp câu trả lời liên quan và chính xác hơn với nhóm người dùng mục tiêu. Repo Prompts For Edu là ví dụ tuyệt vời cho cách này: một thư viện prompt cho lĩnh vực giáo dục, nhấn mạnh các mục tiêu như soạn giáo án, thiết kế chương trình, kèm học sinh…
Nội dung hỗ trợ (supporting content)
Nếu coi prompt gồm một chỉ dẫn (tác vụ) và một đối tượng (nội dung chính), thì nội dung phụ (secondary content) là ngữ cảnh bổ sung để ảnh hưởng tới đầu ra theo cách nào đó. Đó có thể là tham số điều chỉnh, chỉ dẫn định dạng, hệ phân loại chủ đề… giúp model điều chỉnh câu trả lời cho phù hợp mục tiêu hoặc kỳ vọng của người dùng.
Ví dụ: có một danh mục khoá học với metadata đầy đủ (tên, mô tả, cấp độ, tag, giảng viên…) cho mọi khoá trong chương trình:
- ta đặt chỉ dẫn "tóm tắt danh mục khoá học cho học kỳ mùa thu 2023"
- ta dùng nội dung chính để đưa vài ví dụ về đầu ra mong muốn
- ta dùng nội dung phụ để chỉ ra 5 "tag" quan trọng nhất.
Lúc này model có thể tóm tắt theo định dạng của các ví dụ, và nếu một kết quả có nhiều tag, nó sẽ ưu tiên 5 tag được nêu trong nội dung phụ.
Best practice khi viết prompt
Đã biết prompt được cấu trúc thế nào, ta có thể nghĩ tới cách thiết kế chúng theo best practice. Có hai phần: có tư duy đúng và áp dụng đúng kỹ thuật.
Tư duy prompt engineering
Prompt engineering là quá trình thử và sai, nên hãy nhớ ba yếu tố định hướng:
- Hiểu lĩnh vực là quan trọng. Độ chính xác và liên quan của câu trả lời phụ thuộc vào lĩnh vực mà ứng dụng hoặc người dùng hoạt động. Hãy dùng trực giác và chuyên môn để tuỳ biến kỹ thuật thêm. Ví dụ, định nghĩa tính cách theo lĩnh vực trong system prompt, hoặc dùng mẫu theo lĩnh vực trong user prompt. Đưa nội dung phụ phản ánh ngữ cảnh lĩnh vực, hoặc dùng cue và ví dụ theo lĩnh vực để dẫn model tới các cách dùng quen thuộc.
- Hiểu model là quan trọng. Model vốn mang tính ngẫu nhiên. Nhưng các model còn khác nhau về tập dữ liệu huấn luyện (kiến thức sẵn có), khả năng cung cấp (qua API hoặc SDK) và loại nội dung được tối ưu (code, ảnh hay văn bản). Hãy hiểu điểm mạnh và giới hạn của model bạn dùng, và dựa vào đó để ưu tiên tác vụ hoặc xây mẫu tuỳ biến tối ưu cho khả năng của model.
- Lặp và kiểm chứng là quan trọng. Model phát triển rất nhanh, kỹ thuật prompt engineering cũng vậy. Là chuyên gia lĩnh vực, bạn có thể có ngữ cảnh hay tiêu chí riêng cho ứng dụng của bạn mà cộng đồng chung không có. Hãy dùng công cụ và kỹ thuật prompt engineering để "khởi động nhanh" việc dựng prompt, rồi lặp và kiểm chứng kết quả bằng trực giác và chuyên môn của mình. Ghi lại các nhận định và tạo một kho tri thức (như thư viện prompt) để người khác dùng làm nền tảng mới, giúp lặp nhanh hơn về sau.
Các best practice phổ biến
Dưới đây là các best practice phổ biến được OpenAI và những người làm thực tế với Azure OpenAI khuyến nghị.
| Làm gì | Vì sao |
|---|---|
| Đánh giá các model mới nhất | Thế hệ model mới nhiều khả năng có tính năng và chất lượng tốt hơn, nhưng cũng có thể tốn kém hơn. Hãy đánh giá tác động rồi mới quyết định chuyển đổi. |
| Tách chỉ dẫn và ngữ cảnh | Kiểm tra xem model/nhà cung cấp có định nghĩa ký tự phân tách (delimiter) để phân biệt rõ chỉ dẫn, nội dung chính và nội dung phụ không. Điều này giúp model gán trọng số cho token chính xác hơn. |
| Cụ thể và rõ ràng | Nêu chi tiết hơn về ngữ cảnh, kết quả, độ dài, định dạng, phong cách mong muốn… Việc này cải thiện cả chất lượng lẫn độ nhất quán. Lưu các công thức thành mẫu dùng lại. |
| Mô tả kỹ, dùng ví dụ | Model có thể phản hồi tốt hơn với cách "cho xem và giải thích". Bắt đầu bằng zero-shot (chỉ dẫn, không ví dụ), rồi thử few-shot để tinh chỉnh, đưa vài ví dụ về đầu ra mong muốn. Dùng phép so sánh. |
| Dùng cue để mở đầu completion | Đẩy model tới kết quả mong muốn bằng vài từ hoặc cụm từ dẫn dắt làm điểm khởi đầu cho câu trả lời. |
| Nhấn mạnh lại | Đôi khi bạn cần lặp lại với model. Đưa chỉ dẫn cả trước và sau nội dung chính, dùng chỉ dẫn kèm cue… Lặp và kiểm chứng để xem cách nào hiệu quả. |
| Thứ tự quan trọng | Thứ tự trình bày thông tin có thể ảnh hưởng đầu ra, kể cả thứ tự các ví dụ, do thiên kiến gần đây (recency bias). Thử nhiều cách để xem cách nào tốt nhất. |
| Cho model một "lối thoát" | Đưa cho model một câu trả lời dự phòng để dùng nếu vì lý do nào đó không hoàn thành được tác vụ. Việc này giảm khả năng model tạo câu trả lời sai hoặc bịa đặt. |
Như mọi best practice, hãy nhớ rằng kết quả có thể khác nhau tuỳ model, tác vụ và lĩnh vực. Dùng chúng làm điểm xuất phát, rồi lặp để tìm cách hiệu quả nhất với bạn. Liên tục đánh giá lại quy trình prompt engineering khi có model và công cụ mới, tập trung vào khả năng mở rộng quy trình và chất lượng câu trả lời.
Thử thách
Hãy thử kỹ thuật "cue" với prompt: hoàn thành câu "Show me an image of red car of make Volvo and ". Model trả lời gì, và bạn sẽ cải thiện nó thế nào?
Bài tiếp theo: Kỹ thuật prompt nâng cao.
Nguồn
- Dịch và biên tập từ microsoft/generative-ai-for-beginners · 04-prompt-engineering-fundamentals/README.md, giấy phép MIT.