Bài này giới thiệu Retrieval Augmented Generation (RAG), phương pháp cho model ngôn ngữ truy cập nguồn kiến thức bên ngoài để giải các tác vụ cần nhiều kiến thức.
Vì sao cần RAG
Các model ngôn ngữ đa dụng có thể được fine-tuning để làm một số tác vụ phổ biến như phân tích cảm xúc và nhận dạng thực thể có tên. Các tác vụ này nhìn chung không cần thêm kiến thức nền.
Với các tác vụ phức tạp hơn và cần nhiều kiến thức, có thể xây một hệ thống dựa trên model ngôn ngữ, truy cập các nguồn kiến thức bên ngoài để hoàn thành tác vụ. Cách này giúp nhất quán hơn về sự kiện, tăng độ tin cậy của câu trả lời được sinh ra và giúp giảm thiểu vấn đề ảo giác (hallucination).
RAG là gì
Các nhà nghiên cứu của Meta AI đã giới thiệu một phương pháp gọi là Retrieval Augmented Generation (RAG) để giải các tác vụ cần nhiều kiến thức như vậy. RAG kết hợp một thành phần truy xuất thông tin với một model sinh văn bản. RAG có thể được fine-tuning và kiến thức bên trong của nó có thể được thay đổi một cách hiệu quả mà không cần huấn luyện lại toàn bộ model.
RAG nhận một đầu vào và truy xuất một tập tài liệu liên quan/hỗ trợ từ một nguồn (ví dụ Wikipedia). Các tài liệu này được nối làm ngữ cảnh cùng prompt đầu vào gốc rồi đưa cho model sinh văn bản để tạo đầu ra cuối cùng. Điều này giúp RAG thích ứng với các tình huống mà sự kiện có thể thay đổi theo thời gian. Điều này rất hữu ích vì kiến thức tham số (parametric knowledge) của LLM là tĩnh. RAG cho phép model ngôn ngữ không cần huấn luyện lại mà vẫn truy cập được thông tin mới nhất, để sinh đầu ra đáng tin cậy qua việc sinh dựa trên truy xuất.
Lewis et al., (2021) đề xuất một công thức fine-tuning đa dụng cho RAG. Một model seq2seq đã tiền huấn luyện được dùng làm bộ nhớ tham số (parametric memory), và một chỉ mục vector dày đặc của Wikipedia được dùng làm bộ nhớ phi tham số (non-parametric memory), truy cập bằng một bộ truy xuất thần kinh đã tiền huấn luyện. Dưới đây là tổng quan cách tiếp cận hoạt động:
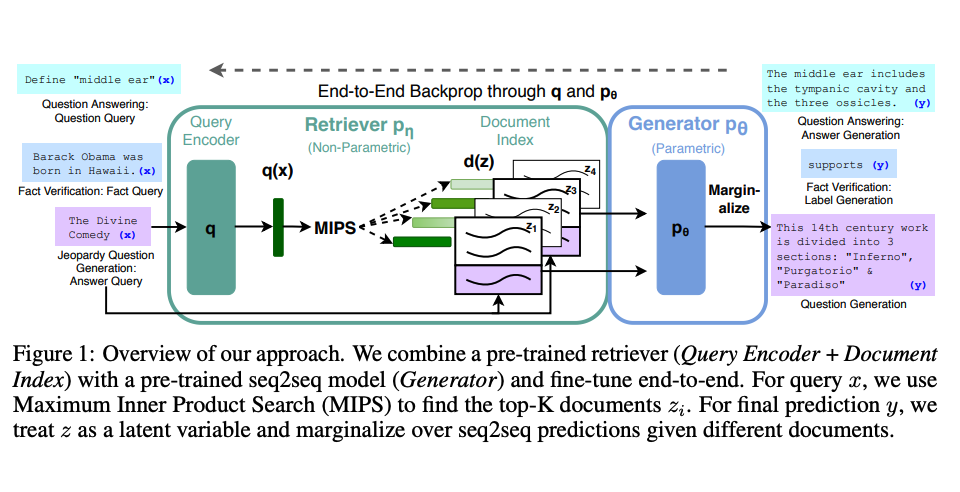
Nguồn ảnh: Lewis et el. (2021)
Kết quả
RAG đạt kết quả mạnh trên nhiều benchmark như Natural Questions, WebQuestions và CuratedTrec. RAG sinh câu trả lời đúng sự kiện hơn, cụ thể hơn và đa dạng hơn khi thử trên các câu hỏi MS-MARCO và Jeopardy. RAG cũng cải thiện kết quả trên FEVER (kiểm chứng sự kiện).
Điều này cho thấy tiềm năng của RAG như một lựa chọn khả thi để nâng cao đầu ra của model ngôn ngữ trong các tác vụ cần nhiều kiến thức.
Gần đây hơn, các cách tiếp cận dựa trên bộ truy xuất này ngày càng phổ biến và được kết hợp với các LLM phổ biến như ChatGPT để cải thiện khả năng và tính nhất quán về sự kiện.
Trường hợp sử dụng RAG: sinh tiêu đề bài báo ML thân thiện
Nhóm tác giả đã chuẩn bị một notebook hướng dẫn dùng LLM mã nguồn mở để xây hệ thống RAG sinh tiêu đề ngắn gọn cho bài báo học máy: Getting Started with RAG.
Tài liệu tham khảo
- Retrieval-Augmented Generation for Large Language Models: A Survey (12/2023)
- Retrieval Augmented Generation: Streamlining the creation of intelligent natural language processing models (9/2020)
Nguồn
- Dịch và biên tập từ dair-ai/Prompt-Engineering-Guide · pages/techniques/rag.en.mdx, giấy phép MIT.