Bài này so sánh các loại mô hình ngôn ngữ lớn (LLM) để thấy ưu, nhược điểm của từng loại, rồi xem cách thử nghiệm, cải thiện và triển khai (deploy) model cho tình huống của bạn.
Video bài học (tiếng Anh): xem trên YouTube.
Ở bài trước, chúng ta đã thấy AI tạo sinh (generative AI) đang thay đổi bối cảnh công nghệ thế nào, LLM hoạt động ra sao và một doanh nghiệp như startup của chúng ta có thể áp dụng chúng vào tình huống của mình để phát triển. Bước tiếp theo trong hành trình của startup là khám phá bối cảnh LLM hiện tại và hiểu model nào phù hợp với tình huống của mình.
Giới thiệu
Bài này gồm:
- Các loại LLM trong bối cảnh hiện tại.
- Thử nghiệm, lặp và so sánh các model cho tình huống của bạn trên Azure.
- Cách triển khai một LLM.
Mục tiêu học tập
Sau bài này, bạn sẽ có thể:
- Chọn đúng model cho tình huống của mình.
- Hiểu cách thử nghiệm, lặp và cải thiện hiệu năng của model.
- Biết doanh nghiệp triển khai model ra sao.
Hiểu các loại LLM
LLM có thể được phân loại theo kiến trúc, dữ liệu huấn luyện và tình huống sử dụng. Hiểu các khác biệt này giúp startup chọn đúng model cho tình huống, đồng thời biết cách thử nghiệm, lặp và cải thiện hiệu năng.
Có rất nhiều loại LLM. Lựa chọn của bạn phụ thuộc vào mục đích sử dụng, dữ liệu của bạn, bạn sẵn sàng trả bao nhiêu và nhiều yếu tố khác. Tuỳ bạn cần sinh văn bản, âm thanh, video hay hình ảnh, bạn có thể chọn loại model khác nhau.
-
Nhận dạng âm thanh và giọng nói. Các model kiểu Whisper vẫn là model nhận dạng giọng nói đa dụng hữu ích, nhưng lựa chọn cho môi trường production nay còn có các model chuyển giọng nói thành văn bản mới hơn như
gpt-4o-transcribe,gpt-4o-mini-transcribevà các biến thể có phân tách người nói (diarization). Hãy đánh giá độ phủ ngôn ngữ, khả năng phân tách người nói, hỗ trợ thời gian thực, độ trễ và chi phí cho tình huống của bạn. Xem thêm trong tài liệu speech-to-text của OpenAI. -
Sinh ảnh. DALL-E và Midjourney là các lựa chọn sinh ảnh nổi tiếng, nhưng API ảnh hiện tại của OpenAI xoay quanh các model GPT Image như
gpt-image-2, trong khi Stable Diffusion, Imagen, Flux và các họ model khác cũng phổ biến. Hãy so sánh mức bám sát prompt, hỗ trợ chỉnh sửa, kiểm soát phong cách, yêu cầu an toàn và giấy phép. Xem thêm trong hướng dẫn sinh ảnh của OpenAI và chương 9 của chương trình. -
Sinh văn bản. Model văn bản nay trải từ model frontier, model suy luận (reasoning), model nhỏ độ trễ thấp đến model open-weight. Ví dụ hiện tại gồm các model OpenAI GPT-5.x, Anthropic Claude 4.x, Google Gemini 3.x, Meta Llama 4 và các model Mistral. Đừng chỉ chọn theo ngày phát hành hay giá; hãy so sánh chất lượng trên tác vụ, độ trễ, cửa sổ ngữ cảnh (context window), khả năng dùng tool, hành vi an toàn, khu vực cung cấp và tổng chi phí. Danh mục model của Microsoft Foundry là nơi tốt để so sánh các model có trên Azure.
-
Đa phương thức (multi-modality). Nhiều model hiện nay xử lý được nhiều hơn văn bản. Có model nhận đầu vào ảnh, âm thanh hoặc video; có model gọi được tool; và các model chuyên biệt có thể sinh ảnh, âm thanh hoặc video. Ví dụ, các model OpenAI hiện tại hỗ trợ đầu vào văn bản và ảnh, model Gemini có thể nhận văn bản, code, ảnh, âm thanh và video tuỳ biến thể, còn Llama 4 Scout và Maverick là model open-weight đa phương thức ngay từ thiết kế. Luôn kiểm tra model card để biết phương thức đầu vào và đầu ra được hỗ trợ trước khi xây quy trình (workflow) quanh model đó.
Chọn một model nghĩa là bạn có một số khả năng (capability) cơ bản, nhưng thế có thể chưa đủ. Thường bạn có dữ liệu riêng của công ty mà bằng cách nào đó phải cho LLM biết. Có vài cách tiếp cận, sẽ nói ở các mục sau.
Foundation Model và LLM
Thuật ngữ Foundation Model được các nhà nghiên cứu Stanford đặt ra, định nghĩa là model AI thoả một số tiêu chí như:
- Được huấn luyện bằng học không giám sát hoặc tự giám sát: huấn luyện trên dữ liệu đa phương thức không gán nhãn, không cần con người chú thích hay gán nhãn dữ liệu.
- Là model rất lớn: dựa trên mạng nơ-ron rất sâu, với hàng tỷ tham số.
- Thường dùng làm "nền móng" cho model khác: có thể làm điểm xuất phát để xây model khác lên trên, bằng cách fine-tuning.
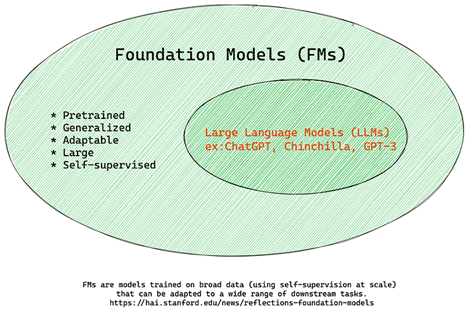
Nguồn ảnh: Essential Guide to Foundation Models and Large Language Models | by Babar M Bhatti | Medium
Để làm rõ khác biệt này, hãy lấy ChatGPT làm ví dụ lịch sử. Các phiên bản đầu của ChatGPT dùng GPT-3.5 làm foundation model. OpenAI sau đó dùng dữ liệu hội thoại và kỹ thuật alignment để tạo một phiên bản tinh chỉnh, hoạt động tốt hơn trong tình huống hội thoại như chatbot. Các dịch vụ AI hiện đại thường định tuyến giữa nhiều biến thể model, nên tên dịch vụ và tên model bên dưới không phải lúc nào cũng là một.
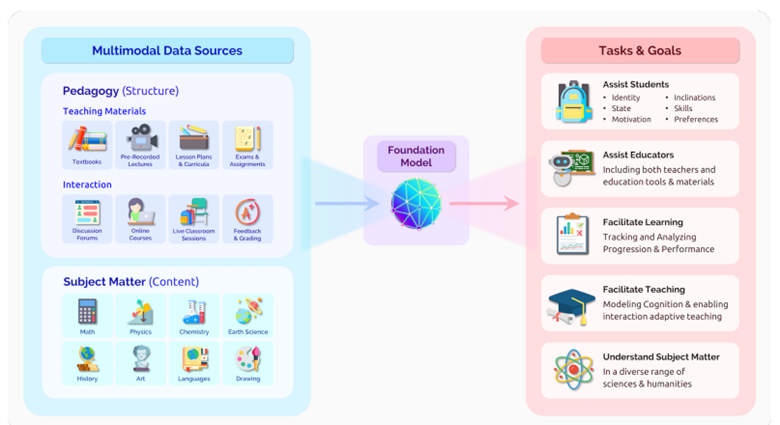
Nguồn ảnh: 2108.07258.pdf (arxiv.org)
Model open-weight/mã nguồn mở và model độc quyền
Một cách phân loại LLM khác là open-weight, mã nguồn mở (open source) hay độc quyền (proprietary).
Model mã nguồn mở và open-weight công khai các thành phần của model để xem xét, tải về hoặc tuỳ biến, nhưng giấy phép của chúng khác nhau. Có model hoàn toàn mã nguồn mở, có model chỉ open-weight kèm hạn chế sử dụng. Chúng hữu ích khi doanh nghiệp cần kiểm soát nhiều hơn về triển khai, vị trí lưu dữ liệu, chi phí hoặc tuỳ biến. Tuy vậy, đội ngũ vẫn cần xem xét điều khoản giấy phép, chi phí vận hành, bảo trì, cập nhật bảo mật và chất lượng đánh giá trước khi dùng trong production. Ví dụ: Meta Llama 4, một số model Mistral và nhiều model trên Hugging Face.
Model độc quyền do một nhà cung cấp sở hữu và vận hành. Các model này thường được tối ưu cho production có quản lý, có hỗ trợ tốt, hệ thống an toàn, tích hợp (integration) tool và khả năng mở rộng. Tuy nhiên, khách hàng thường không xem hay sửa được trọng số model, và phải đọc điều khoản của nhà cung cấp về quyền riêng tư, lưu giữ dữ liệu, tuân thủ và mục đích sử dụng được phép. Ví dụ: các model OpenAI, Google Gemini và Anthropic Claude.
Embedding, sinh ảnh, sinh văn bản và code
LLM cũng có thể phân loại theo loại đầu ra.
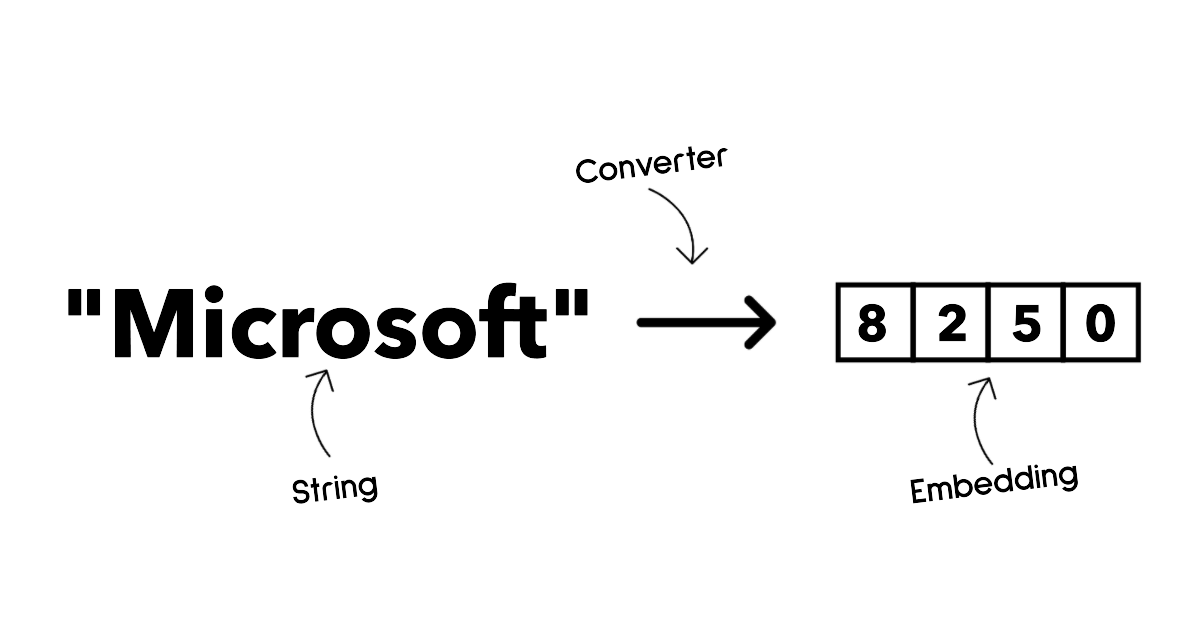
Embedding là nhóm model chuyển văn bản thành dạng số, gọi là embedding, tức biểu diễn số của văn bản đầu vào. Embedding giúp máy dễ hiểu quan hệ giữa các từ hoặc câu, và có thể làm đầu vào cho model khác, như model phân loại hay phân cụm vốn hoạt động tốt hơn trên dữ liệu số. Model embedding thường dùng cho transfer learning: xây một model cho một tác vụ thay thế có nhiều dữ liệu, rồi dùng lại trọng số (embedding) cho các tác vụ khác. Ví dụ là OpenAI embeddings.
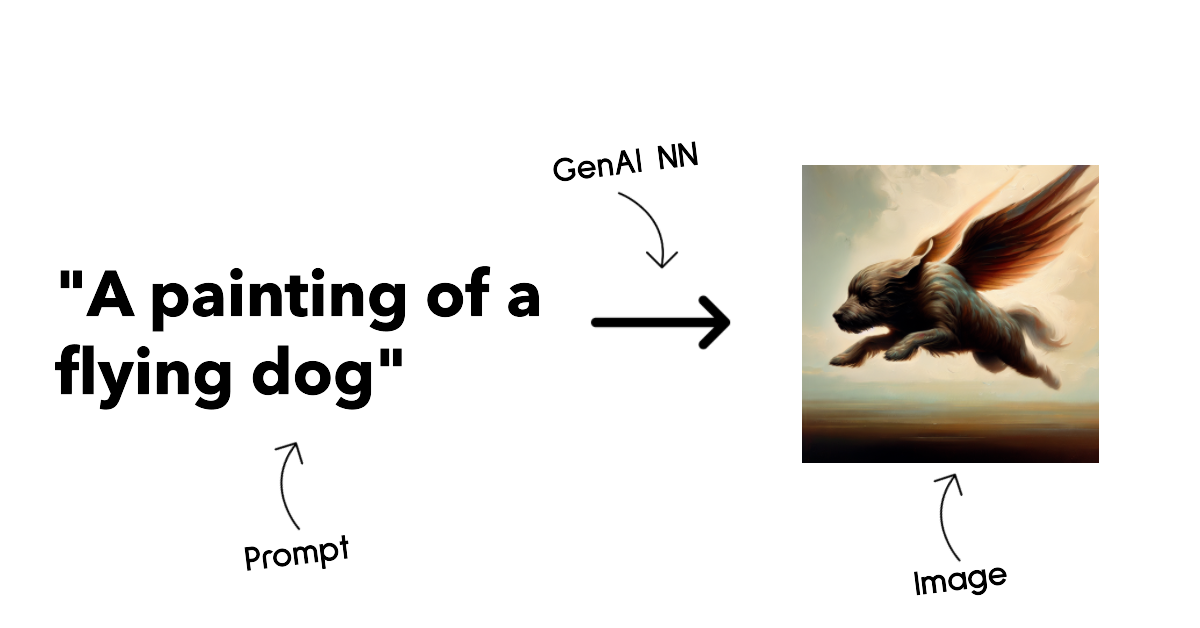
Model sinh ảnh là model tạo ra hình ảnh, thường dùng để chỉnh sửa, tổng hợp và chuyển đổi ảnh. Chúng thường được huấn luyện trên tập ảnh lớn như LAION-5B, và có thể tạo ảnh mới hoặc sửa ảnh có sẵn bằng các kỹ thuật inpainting, tăng độ phân giải (super-resolution) và tô màu. Ví dụ: các model GPT Image, các model Stable Diffusion và các model Imagen.
Model sinh văn bản và code tạo ra văn bản hoặc code, thường dùng để tóm tắt, dịch và hỏi đáp. Model sinh văn bản thường được huấn luyện trên tập văn bản lớn như BookCorpus, dùng để sinh văn bản mới hoặc trả lời câu hỏi. Model sinh code như CodeParrot thường được huấn luyện trên tập code lớn, như từ GitHub, dùng để viết code mới hoặc sửa lỗi trong code có sẵn.
Encoder-Decoder và Decoder-only
Để nói về các kiến trúc LLM, hãy dùng một phép so sánh.
Giả sử quản lý giao bạn viết một bài quiz cho học sinh. Bạn có hai đồng nghiệp: một người lo soạn nội dung, người kia lo duyệt.
Người soạn nội dung giống model decoder-only: họ xem chủ đề, xem những gì bạn đã viết, rồi viết tiếp dựa trên ngữ cảnh đó. Họ rất giỏi viết nội dung hấp dẫn và nhiều thông tin, nhưng không phải lựa chọn tốt nhất khi tác vụ chỉ là phân loại, truy xuất hay mã hoá thông tin. Ví dụ họ model decoder-only: GPT và Llama.
Người duyệt giống model encoder-only: họ xem bài đã viết và các đáp án, nhận ra quan hệ giữa chúng và hiểu ngữ cảnh, nhưng không giỏi tạo nội dung. Ví dụ model encoder-only: BERT.
Nếu có một người vừa soạn vừa duyệt quiz được, đó là model encoder-decoder. Ví dụ: BART và T5.
Dịch vụ và model
Giờ hãy nói về khác biệt giữa dịch vụ (service) và model. Dịch vụ là sản phẩm do nhà cung cấp cloud đưa ra, thường kết hợp model, dữ liệu và các thành phần khác. Model là thành phần cốt lõi của dịch vụ, thường là một foundation model như LLM.
Dịch vụ thường được tối ưu cho production và dễ dùng hơn model, qua giao diện đồ hoạ. Tuy nhiên, dịch vụ không phải lúc nào cũng miễn phí, có thể cần đăng ký hoặc trả phí, đổi lại bạn tận dụng thiết bị và tài nguyên của chủ dịch vụ, tối ưu chi phí và mở rộng dễ dàng. Ví dụ là Azure OpenAI Service, có gói trả theo mức dùng (pay-as-you-go): người dùng trả tiền tỷ lệ với lượng sử dụng. Azure OpenAI Service còn cung cấp bảo mật cấp doanh nghiệp và khung AI có trách nhiệm (Responsible AI) bên trên khả năng của model.
Model là các thành phần mạng nơ-ron: tham số, trọng số, kiến trúc, tokenizer và cấu hình đi kèm. Chạy model ở máy local hoặc môi trường riêng cần phần cứng phù hợp, hạ tầng phục vụ, giám sát, và giấy phép mã nguồn mở/open-weight tương thích hoặc giấy phép thương mại. Các model open-weight như Llama 4 hay Mistral có thể tự host, nhưng vẫn cần sức tính toán và chuyên môn vận hành.
Thử nghiệm và lặp với các model trên Azure
Khi đội ngũ đã khám phá bối cảnh LLM và chọn ra vài ứng viên tốt cho tình huống của mình, bước tiếp theo là thử chúng trên dữ liệu và khối lượng công việc thật. Đây là quá trình lặp, qua thí nghiệm và đo lường. Phần lớn model nhắc tới ở trên (model OpenAI, model open-weight như Llama 4 và Mistral, và model Hugging Face) đều có trong Microsoft Foundry Models.
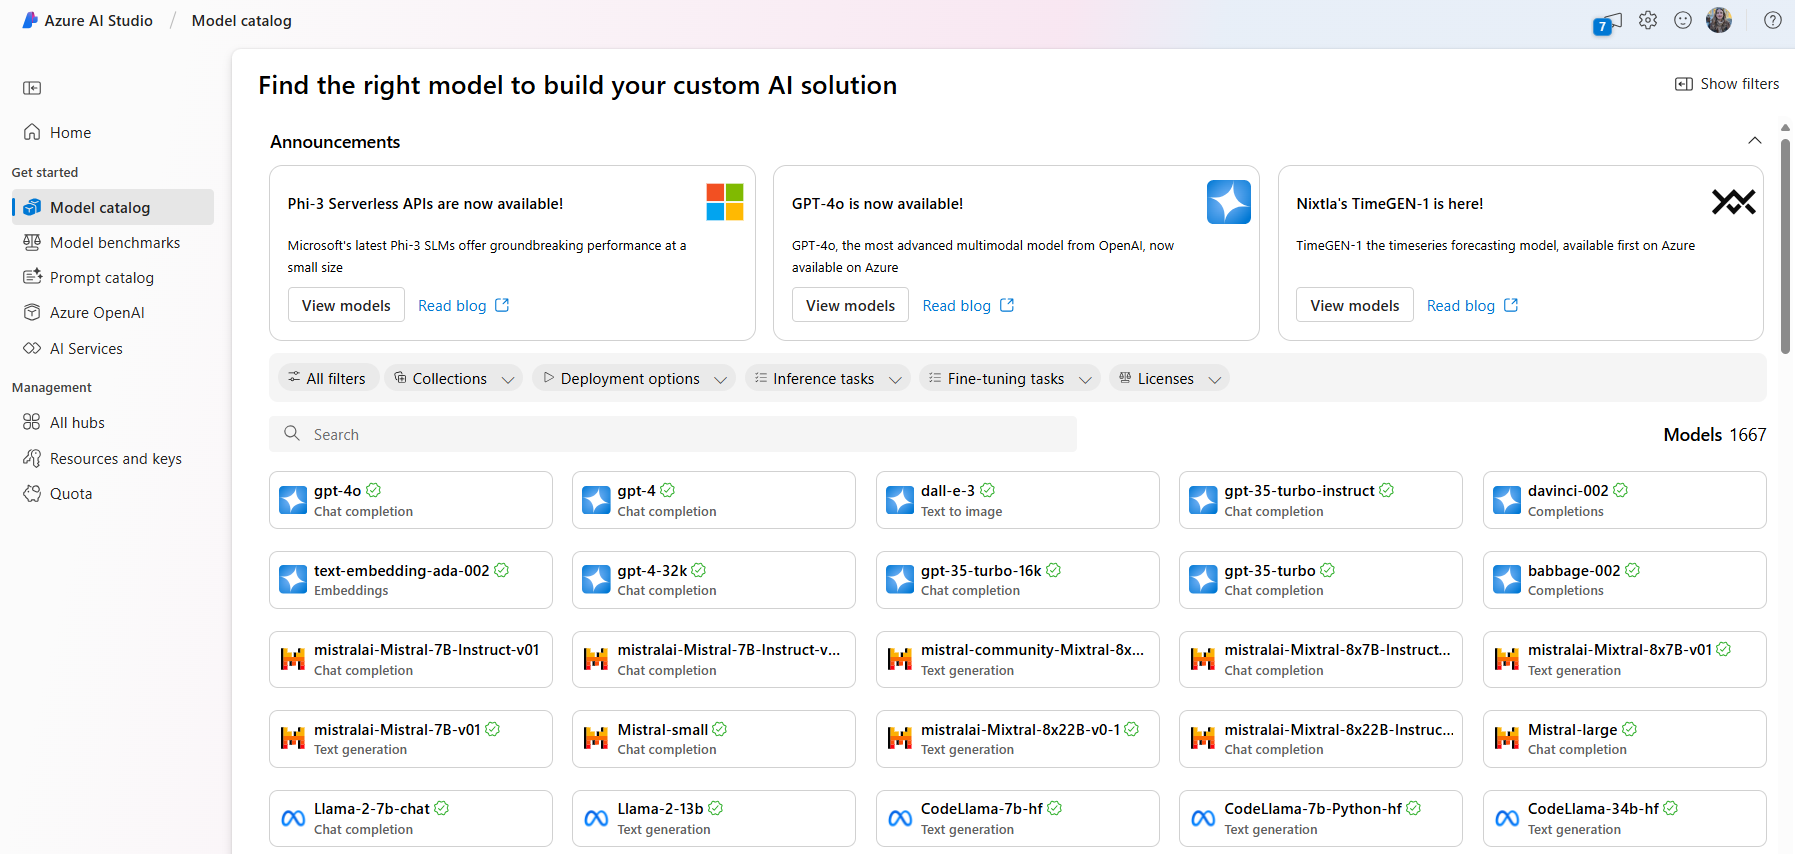
Microsoft Foundry, trước đây là Azure AI Studio/Azure AI Foundry, là nền tảng Azure hợp nhất để xây ứng dụng AI và agent. Nó giúp lập trình viên quản lý vòng đời từ thử nghiệm, đánh giá đến triển khai, giám sát và quản trị. Danh mục model trong Microsoft Foundry cho phép bạn:
- Tìm foundation model cần dùng trong danh mục, gồm model do Azure bán và model từ đối tác, cộng đồng. Có thể lọc theo tác vụ, nhà cung cấp, giấy phép, cách triển khai hoặc tên.
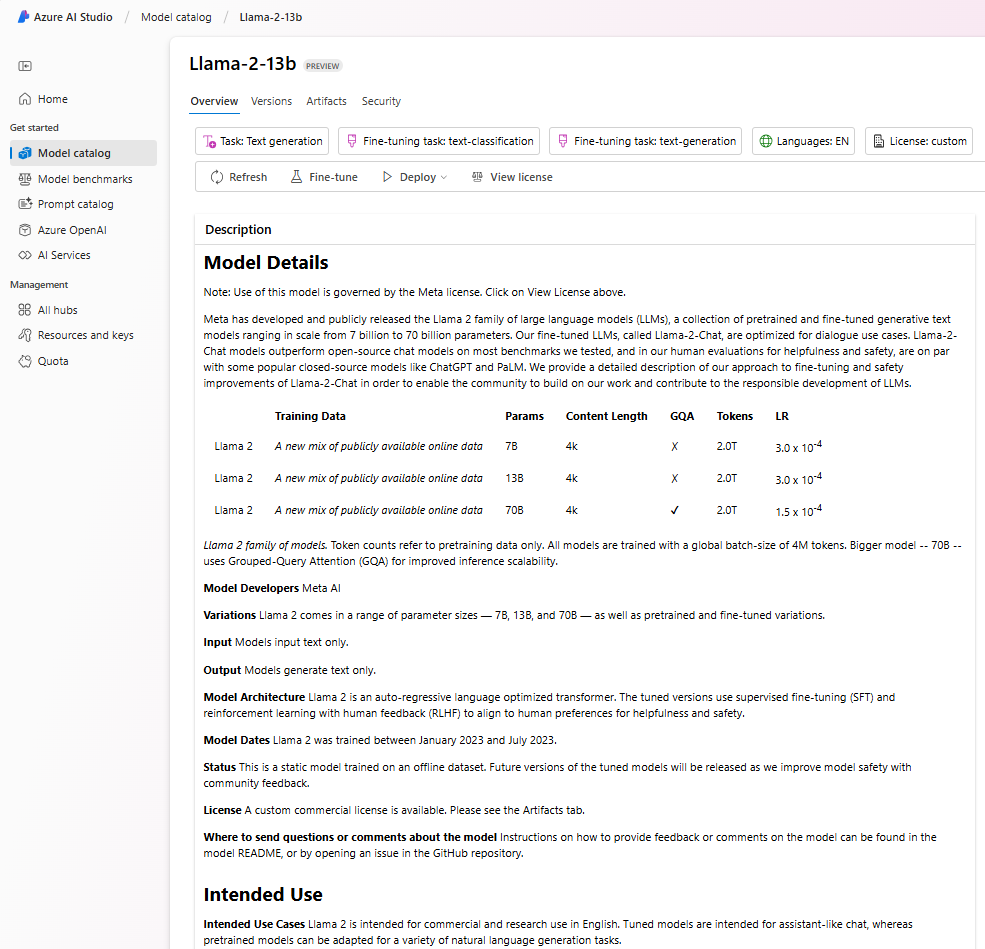
- Xem model card, gồm mô tả chi tiết mục đích sử dụng và dữ liệu huấn luyện, code mẫu và kết quả đánh giá trên thư viện đánh giá nội bộ.
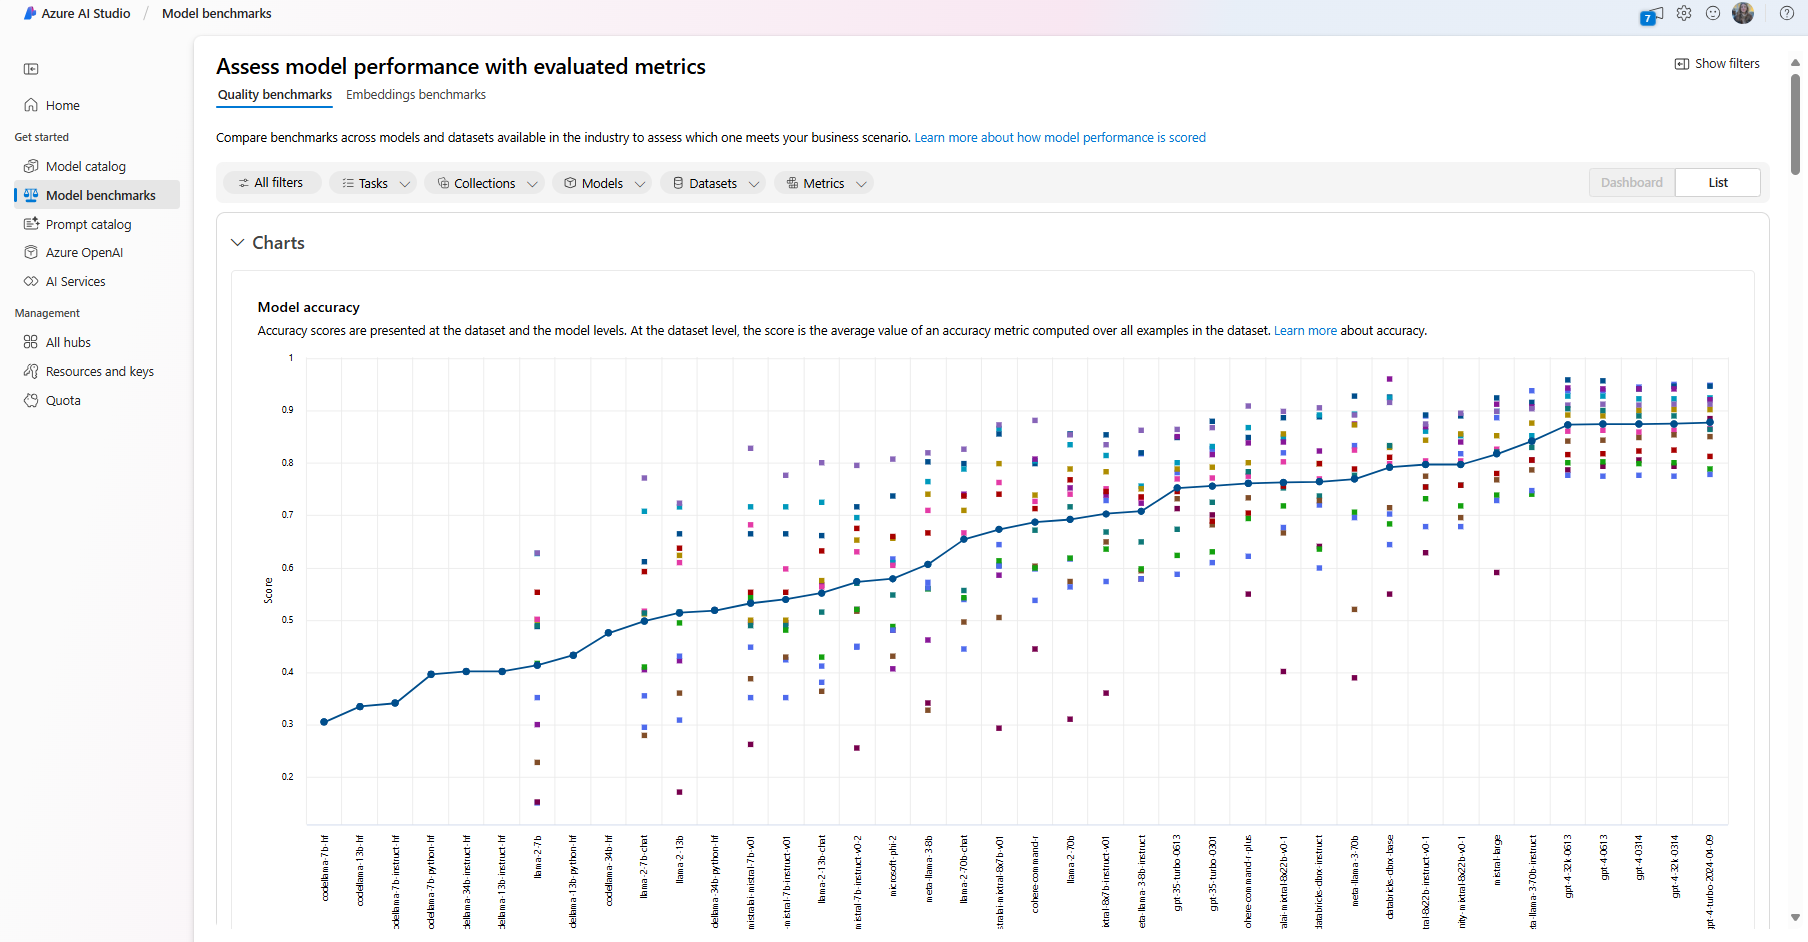
- So sánh benchmark giữa các model và bộ dữ liệu phổ biến trong ngành để xem model nào đáp ứng tình huống kinh doanh, qua mục Model Benchmarks.
- Fine-tuning các model được hỗ trợ trên dữ liệu huấn luyện riêng để cải thiện hiệu năng cho một khối lượng công việc cụ thể, tận dụng khả năng thử nghiệm và theo dõi của Microsoft Foundry.
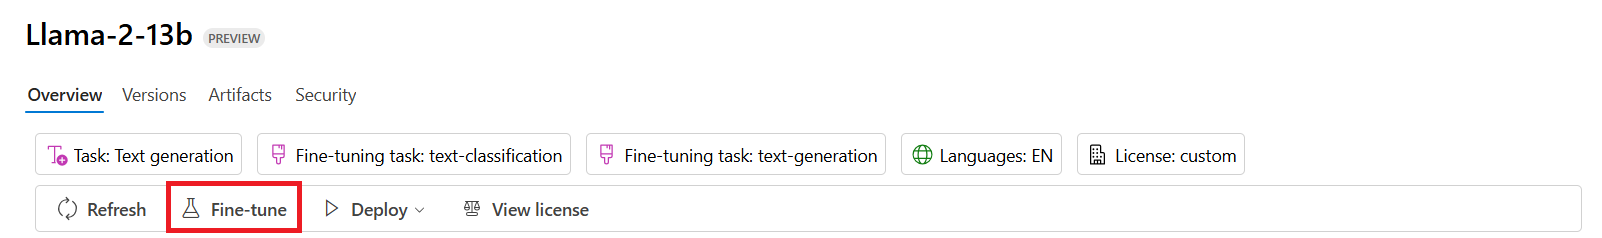
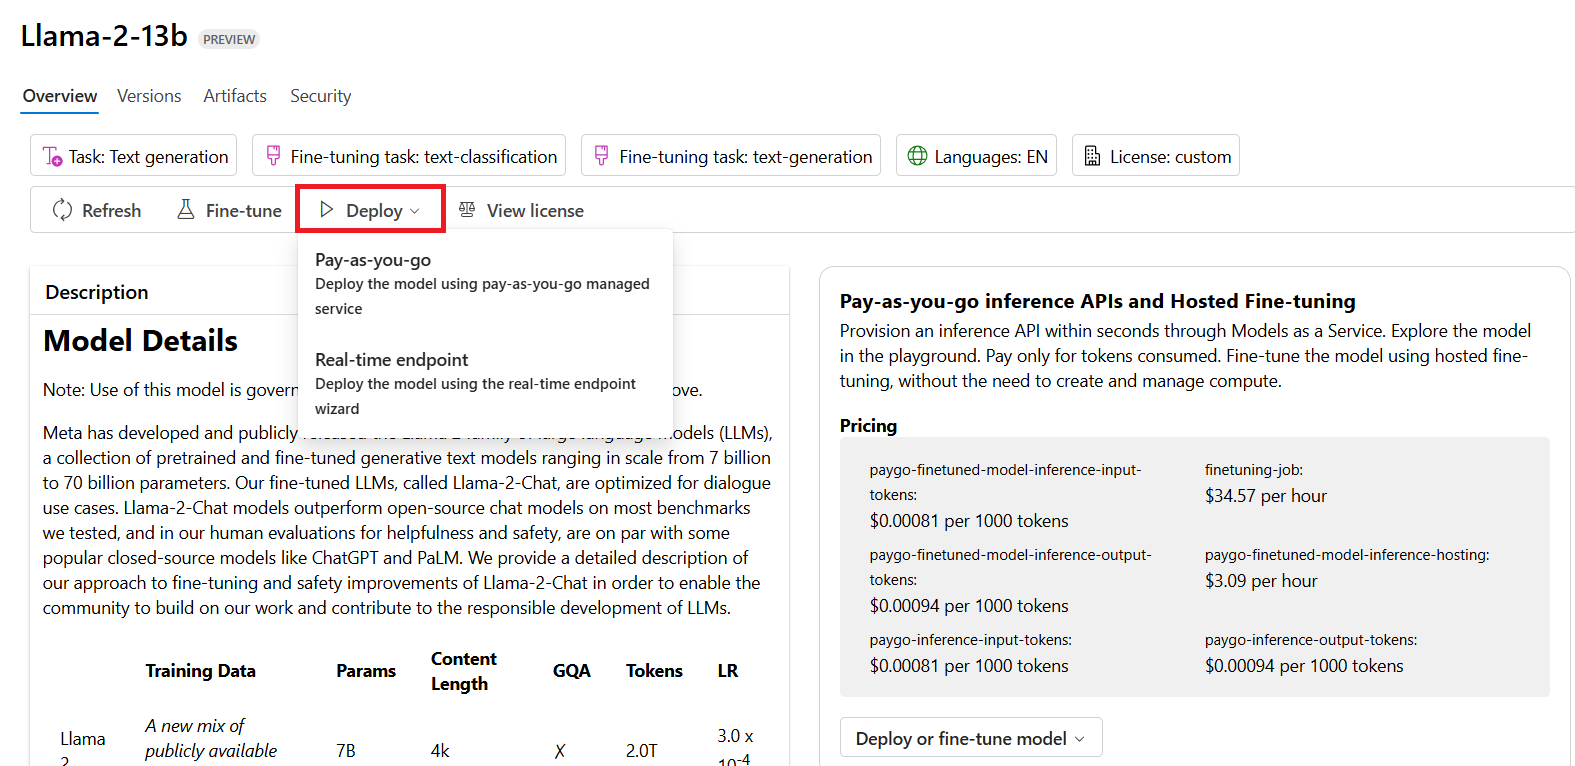
- Triển khai model gốc đã huấn luyện sẵn hoặc bản đã fine-tuning lên một endpoint suy luận (inference) thời gian thực, dùng compute có quản lý hoặc serverless, để ứng dụng gọi tới.
Cải thiện kết quả của LLM
Chúng ta đã cùng startup khám phá các loại LLM và một nền tảng cloud (Microsoft Foundry) cho phép so sánh model, đánh giá trên dữ liệu thử, cải thiện hiệu năng và triển khai lên endpoint suy luận.
Nhưng khi nào nên fine-tuning thay vì dùng model huấn luyện sẵn? Có cách nào khác để cải thiện hiệu năng trên khối lượng công việc cụ thể không?
Doanh nghiệp có nhiều cách để nhận được kết quả mong muốn từ LLM. Khi triển khai LLM vào production, bạn có thể chọn các loại model với mức huấn luyện khác nhau, kèm mức độ phức tạp, chi phí và chất lượng khác nhau:
- Prompt engineering kèm ngữ cảnh. Ý tưởng là cung cấp đủ ngữ cảnh khi viết prompt để nhận được câu trả lời cần thiết.
- Retrieval Augmented Generation (RAG). Dữ liệu của bạn có thể nằm trong cơ sở dữ liệu hoặc một web endpoint; để dữ liệu đó (hoặc một phần) có mặt lúc gửi prompt, bạn lấy dữ liệu liên quan và đưa nó vào prompt của người dùng.
- Model đã fine-tuning. Bạn huấn luyện thêm model trên dữ liệu của mình, giúp model chính xác và đáp ứng nhu cầu tốt hơn, nhưng có thể tốn kém.
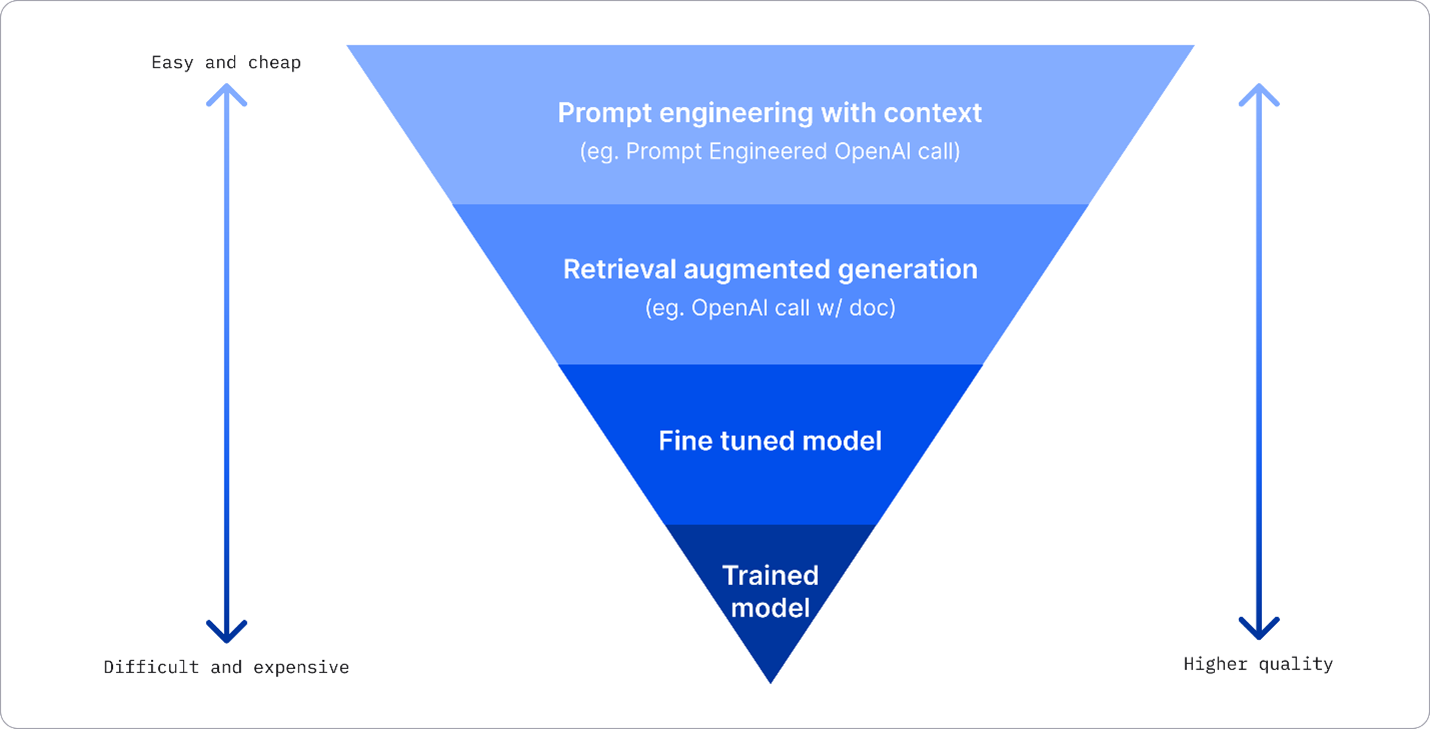
Nguồn ảnh: Four Ways that Enterprises Deploy LLMs | Fiddler AI Blog
Prompt engineering kèm ngữ cảnh
LLM huấn luyện sẵn hoạt động rất tốt với các tác vụ ngôn ngữ tự nhiên tổng quát, kể cả khi gọi bằng prompt ngắn như một câu cần viết tiếp hay một câu hỏi, gọi là học "zero-shot".
Tuy nhiên, người dùng càng mô tả rõ truy vấn, với yêu cầu chi tiết và ví dụ (tức ngữ cảnh), câu trả lời càng chính xác và gần kỳ vọng. Khi prompt có đúng một ví dụ, ta gọi là học "one-shot"; có nhiều ví dụ là "few-shot". Prompt engineering kèm ngữ cảnh là cách tiết kiệm chi phí nhất để bắt đầu.
Retrieval Augmented Generation (RAG)
LLM có giới hạn là chỉ dùng được dữ liệu đã có trong quá trình huấn luyện để trả lời. Nghĩa là chúng không biết gì về sự kiện xảy ra sau khi huấn luyện, và không truy cập được thông tin không công khai (như dữ liệu công ty). Có thể khắc phục bằng RAG, kỹ thuật bổ sung dữ liệu ngoài vào prompt dưới dạng các đoạn (chunk) tài liệu, có tính tới giới hạn độ dài prompt. Việc này được hỗ trợ bởi các công cụ cơ sở dữ liệu vector (vector database), như Azure Vector Search, giúp truy xuất các đoạn hữu ích từ nhiều nguồn dữ liệu định sẵn và thêm vào ngữ cảnh của prompt.
Kỹ thuật này rất hữu ích khi doanh nghiệp không có đủ dữ liệu, thời gian hay tài nguyên để fine-tuning LLM, nhưng vẫn muốn cải thiện hiệu năng trên một khối lượng công việc cụ thể và giảm rủi ro câu trả lời bị ảo giác (hallucination), lỗi thời hoặc không có căn cứ.
Model đã fine-tuning
Fine-tuning là quá trình tận dụng transfer learning để "điều chỉnh" model cho một tác vụ hạ nguồn hoặc một bài toán cụ thể. Khác với few-shot và RAG, nó tạo ra một model mới với trọng số và bias đã cập nhật. Cần một tập ví dụ huấn luyện, mỗi ví dụ gồm một đầu vào (prompt) và đầu ra tương ứng (completion). Đây là cách nên chọn khi:
- Dùng model nhỏ chuyên tác vụ. Doanh nghiệp muốn fine-tuning một model nhỏ cho một tác vụ hẹp thay vì liên tục gửi prompt cho một model frontier lớn, giúp giải pháp rẻ hơn và nhanh hơn.
- Cân nhắc độ trễ. Độ trễ quan trọng với tình huống cụ thể, nên không thể dùng prompt rất dài, hoặc số ví dụ model cần học không vừa giới hạn độ dài prompt.
- Cần hành vi ổn định. Doanh nghiệp có nhiều ví dụ chất lượng cao và muốn model luôn tuân theo một khuôn mẫu tác vụ, định dạng đầu ra, giọng điệu hay phong cách chuyên ngành. Nếu vấn đề chính là dữ kiện mới hoặc tri thức riêng thay đổi thường xuyên, hãy dùng RAG thay vì chỉ dựa vào fine-tuning.
Model tự huấn luyện
Huấn luyện LLM từ đầu chắc chắn là cách khó và phức tạp nhất, cần lượng dữ liệu khổng lồ, nhân lực giỏi và sức tính toán phù hợp. Chỉ nên cân nhắc khi doanh nghiệp có tình huống chuyên ngành và lượng lớn dữ liệu của chuyên ngành đó.
Thử thách
Đọc thêm về cách dùng RAG cho doanh nghiệp của bạn.
Bài tiếp theo: Dùng AI tạo sinh có trách nhiệm.
Nguồn
- Dịch và biên tập từ microsoft/generative-ai-for-beginners · 02-exploring-and-comparing-different-llms/README.md, giấy phép MIT.