Khi AI agent chuyển từ bản mẫu thử nghiệm sang ứng dụng thực tế, khả năng hiểu hành vi, giám sát hiệu năng và đánh giá đầu ra của chúng một cách có hệ thống trở nên quan trọng.
Video của bài: AI Agents in Production.
Mục tiêu học tập
Sau bài này, bạn sẽ biết/hiểu:
- Các khái niệm cốt lõi về khả năng quan sát (observability) và đánh giá agent
- Các kỹ thuật cải thiện hiệu năng, chi phí và hiệu quả của agent
- Đánh giá AI agent cái gì và bằng cách nào một cách có hệ thống
- Cách kiểm soát chi phí khi triển khai AI agent lên production
- Cách instrument các agent xây bằng Microsoft Agent Framework
Mục tiêu là trang bị cho bạn kiến thức để biến những agent "hộp đen" thành hệ thống minh bạch, quản lý được và đáng tin cậy.
Trace và span
Các tool quan sát như Langfuse hay Microsoft Foundry thường biểu diễn các lượt chạy agent dưới dạng trace và span.
- Trace đại diện cho một tác vụ hoàn chỉnh của agent từ đầu đến cuối (như xử lý một câu hỏi của người dùng).
- Span là các bước riêng lẻ bên trong trace (như gọi model ngôn ngữ hoặc truy xuất dữ liệu).
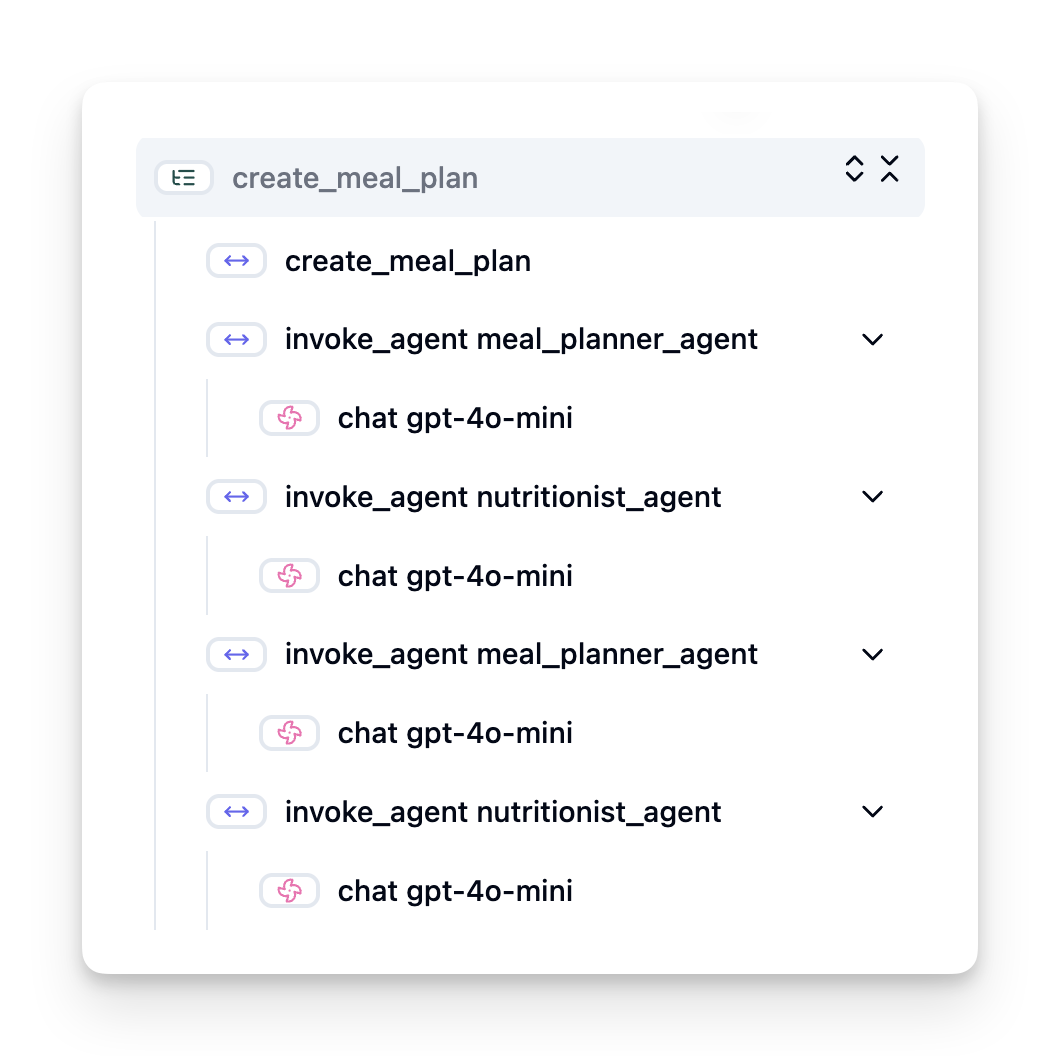
Không có khả năng quan sát, AI agent có thể giống một "hộp đen": trạng thái bên trong và suy luận của nó không nhìn thấy được, khiến việc chẩn đoán sự cố hay tối ưu hiệu năng rất khó. Có khả năng quan sát, agent trở thành "hộp kính", mang lại sự minh bạch rất cần để xây dựng niềm tin và đảm bảo chúng hoạt động đúng ý định.
Vì sao khả năng quan sát quan trọng trong production
Đưa AI agent lên production kéo theo một loạt thách thức và yêu cầu mới. Khả năng quan sát không còn là thứ "có thì tốt" mà là năng lực then chốt:
- Gỡ lỗi và phân tích nguyên nhân gốc: khi agent thất bại hoặc cho đầu ra bất ngờ, tool quan sát cung cấp các trace cần thiết để xác định nguồn gốc lỗi. Điều này đặc biệt quan trọng với các agent phức tạp có thể gồm nhiều lời gọi LLM, tương tác tool và logic điều kiện.
- Quản lý độ trễ và chi phí: AI agent thường dựa vào LLM và các API bên ngoài tính phí theo token hoặc theo lời gọi. Khả năng quan sát cho phép theo dõi chính xác các lời gọi này, giúp xác định thao tác quá chậm hoặc quá tốn kém. Nhờ đó các nhóm có thể tối ưu prompt, chọn model hiệu quả hơn hoặc thiết kế lại quy trình để quản lý chi phí vận hành và đảm bảo trải nghiệm người dùng tốt.
- Niềm tin, an toàn và tuân thủ: trong nhiều ứng dụng, cần đảm bảo agent hành xử an toàn và có đạo đức. Khả năng quan sát cung cấp dấu vết kiểm toán về hành động và quyết định của agent. Có thể dùng nó để phát hiện và giảm thiểu các vấn đề như prompt injection, sinh nội dung độc hại hay xử lý sai thông tin định danh cá nhân (PII). Ví dụ, bạn có thể xem lại trace để hiểu vì sao agent đưa ra một câu trả lời nhất định hoặc dùng một tool cụ thể.
- Vòng cải tiến liên tục: dữ liệu quan sát là nền tảng của quy trình phát triển lặp. Bằng cách giám sát agent hoạt động ngoài thực tế, các nhóm có thể tìm ra chỗ cần cải thiện, thu thập dữ liệu để fine-tuning model và xác nhận tác động của các thay đổi. Điều này tạo ra một vòng phản hồi, nơi hiểu biết từ đánh giá online trên production định hướng cho việc thử nghiệm và tinh chỉnh offline, giúp hiệu năng agent ngày càng tốt hơn.
Các chỉ số chính cần theo dõi
Để giám sát và hiểu hành vi của agent, cần theo dõi một loạt chỉ số và tín hiệu. Dù chỉ số cụ thể có thể khác nhau tuỳ mục đích của agent, một số chỉ số quan trọng ở mọi nơi.
Đây là một số chỉ số phổ biến nhất mà tool quan sát giám sát:
Độ trễ: agent phản hồi nhanh đến mức nào? Thời gian chờ lâu ảnh hưởng xấu đến trải nghiệm người dùng. Bạn nên đo độ trễ cho cả tác vụ và từng bước bằng cách trace các lượt chạy agent. Ví dụ, một agent mất 20 giây cho mọi lời gọi model có thể được tăng tốc bằng cách dùng model nhanh hơn hoặc chạy các lời gọi model song song.
Chi phí: mỗi lượt chạy agent tốn bao nhiêu? AI agent dựa vào lời gọi LLM tính phí theo token hoặc API bên ngoài. Dùng tool thường xuyên hay nhiều prompt có thể làm chi phí tăng nhanh. Chẳng hạn, nếu agent gọi LLM năm lần chỉ để cải thiện chất lượng chút ít, bạn phải đánh giá chi phí đó có đáng không, hay có thể giảm số lời gọi hoặc dùng model rẻ hơn. Giám sát theo thời gian thực cũng giúp phát hiện các đợt tăng đột biến bất ngờ (ví dụ lỗi gây vòng lặp API quá mức).
Lỗi yêu cầu: agent đã thất bại bao nhiêu yêu cầu? Có thể gồm lỗi API hoặc lời gọi tool thất bại. Để agent vững vàng hơn trước các lỗi này trên production, bạn có thể thiết lập cơ chế dự phòng hoặc thử lại. Ví dụ, nếu nhà cung cấp LLM A ngừng hoạt động, bạn chuyển sang nhà cung cấp LLM B để dự phòng.
Phản hồi của người dùng: cho phép người dùng đánh giá trực tiếp mang lại hiểu biết giá trị. Có thể gồm đánh giá tường minh (thích/không thích, 1-5 sao) hoặc bình luận bằng văn bản. Phản hồi tiêu cực lặp đi lặp lại nên khiến bạn cảnh giác, vì đó là dấu hiệu agent không hoạt động như mong đợi.
Phản hồi ngầm của người dùng: hành vi người dùng cung cấp phản hồi gián tiếp ngay cả khi không có đánh giá tường minh. Có thể gồm việc diễn đạt lại câu hỏi ngay lập tức, hỏi lặp lại hoặc bấm nút thử lại. Ví dụ, nếu thấy người dùng hỏi lặp lại cùng một câu, đó là dấu hiệu agent không hoạt động như mong đợi.
Độ chính xác: agent tạo ra đầu ra đúng hoặc như mong muốn thường xuyên đến mức nào? Định nghĩa độ chính xác khác nhau (ví dụ giải đúng vấn đề, truy xuất thông tin chính xác, mức hài lòng của người dùng). Bước đầu tiên là định nghĩa thành công trông như thế nào với agent của bạn. Bạn có thể theo dõi độ chính xác qua kiểm tra tự động, điểm đánh giá hoặc nhãn hoàn thành tác vụ. Ví dụ, đánh dấu trace là "succeeded" (thành công) hoặc "failed" (thất bại).
Chỉ số đánh giá tự động: bạn cũng có thể thiết lập đánh giá tự động. Ví dụ, dùng một LLM chấm điểm đầu ra của agent, chẳng hạn có hữu ích, chính xác hay không. Cũng có một số thư viện mã nguồn mở giúp chấm các khía cạnh khác nhau của agent. Ví dụ RAGAS cho agent RAG hoặc LLM Guard để phát hiện ngôn ngữ độc hại hay prompt injection.
Trong thực tế, kết hợp các chỉ số này cho độ bao phủ tốt nhất về "sức khoẻ" của AI agent. Trong notebook ví dụ của chương này, chúng ta sẽ thấy các chỉ số này trông thế nào trong ví dụ thực tế, nhưng trước hết hãy tìm hiểu một quy trình đánh giá điển hình.
Instrument agent
Để thu thập dữ liệu trace, bạn cần instrument (gắn đo đạc vào) code. Mục tiêu là instrument code của agent để phát ra trace và chỉ số mà một nền tảng quan sát có thể thu, xử lý và trực quan hoá.
OpenTelemetry (OTel): OpenTelemetry đã trở thành chuẩn ngành cho khả năng quan sát LLM. Nó cung cấp bộ API, SDK và tool để tạo, thu thập và xuất dữ liệu telemetry.
Có nhiều thư viện instrument bọc quanh các framework agent sẵn có và giúp dễ dàng xuất span OpenTelemetry tới một tool quan sát. Microsoft Agent Framework tích hợp sẵn với OpenTelemetry. Dưới đây là ví dụ instrument một agent MAF:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
Notebook ví dụ trong chương này sẽ minh hoạ cách instrument agent MAF của bạn.
Tạo span thủ công: dù các thư viện instrument cho một nền tảng tốt, thường vẫn có trường hợp cần thông tin chi tiết hoặc tuỳ chỉnh hơn. Bạn có thể tạo span thủ công để thêm logic ứng dụng tuỳ chỉnh. Quan trọng hơn, chúng có thể làm giàu các span (tạo tự động hay thủ công) bằng thuộc tính tuỳ chỉnh (còn gọi là tag hay metadata). Các thuộc tính này có thể gồm dữ liệu đặc thù nghiệp vụ, kết quả tính toán trung gian hoặc bất kỳ ngữ cảnh nào hữu ích cho việc gỡ lỗi hay phân tích, như user_id, session_id hay model_version.
Ví dụ tạo trace và span thủ công với Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Đánh giá agent
Khả năng quan sát cho chúng ta chỉ số, còn đánh giá là quá trình phân tích dữ liệu đó (và chạy các bài kiểm tra) để xác định AI agent đang hoạt động tốt đến đâu và có thể cải thiện thế nào. Nói cách khác, khi đã có trace và chỉ số, bạn dùng chúng thế nào để đánh giá agent và ra quyết định?
Đánh giá thường xuyên rất quan trọng vì AI agent thường không tất định (non-deterministic) và có thể thay đổi (qua các bản cập nhật hoặc hành vi model bị trôi). Không có đánh giá, bạn sẽ không biết "agent thông minh" của mình có thật sự làm tốt việc hay đã thoái lui.
Có hai nhóm đánh giá AI agent: đánh giá online và đánh giá offline. Cả hai đều giá trị và bổ trợ cho nhau. Chúng ta thường bắt đầu bằng đánh giá offline, vì đây là bước tối thiểu cần làm trước khi triển khai bất kỳ agent nào.
Đánh giá offline
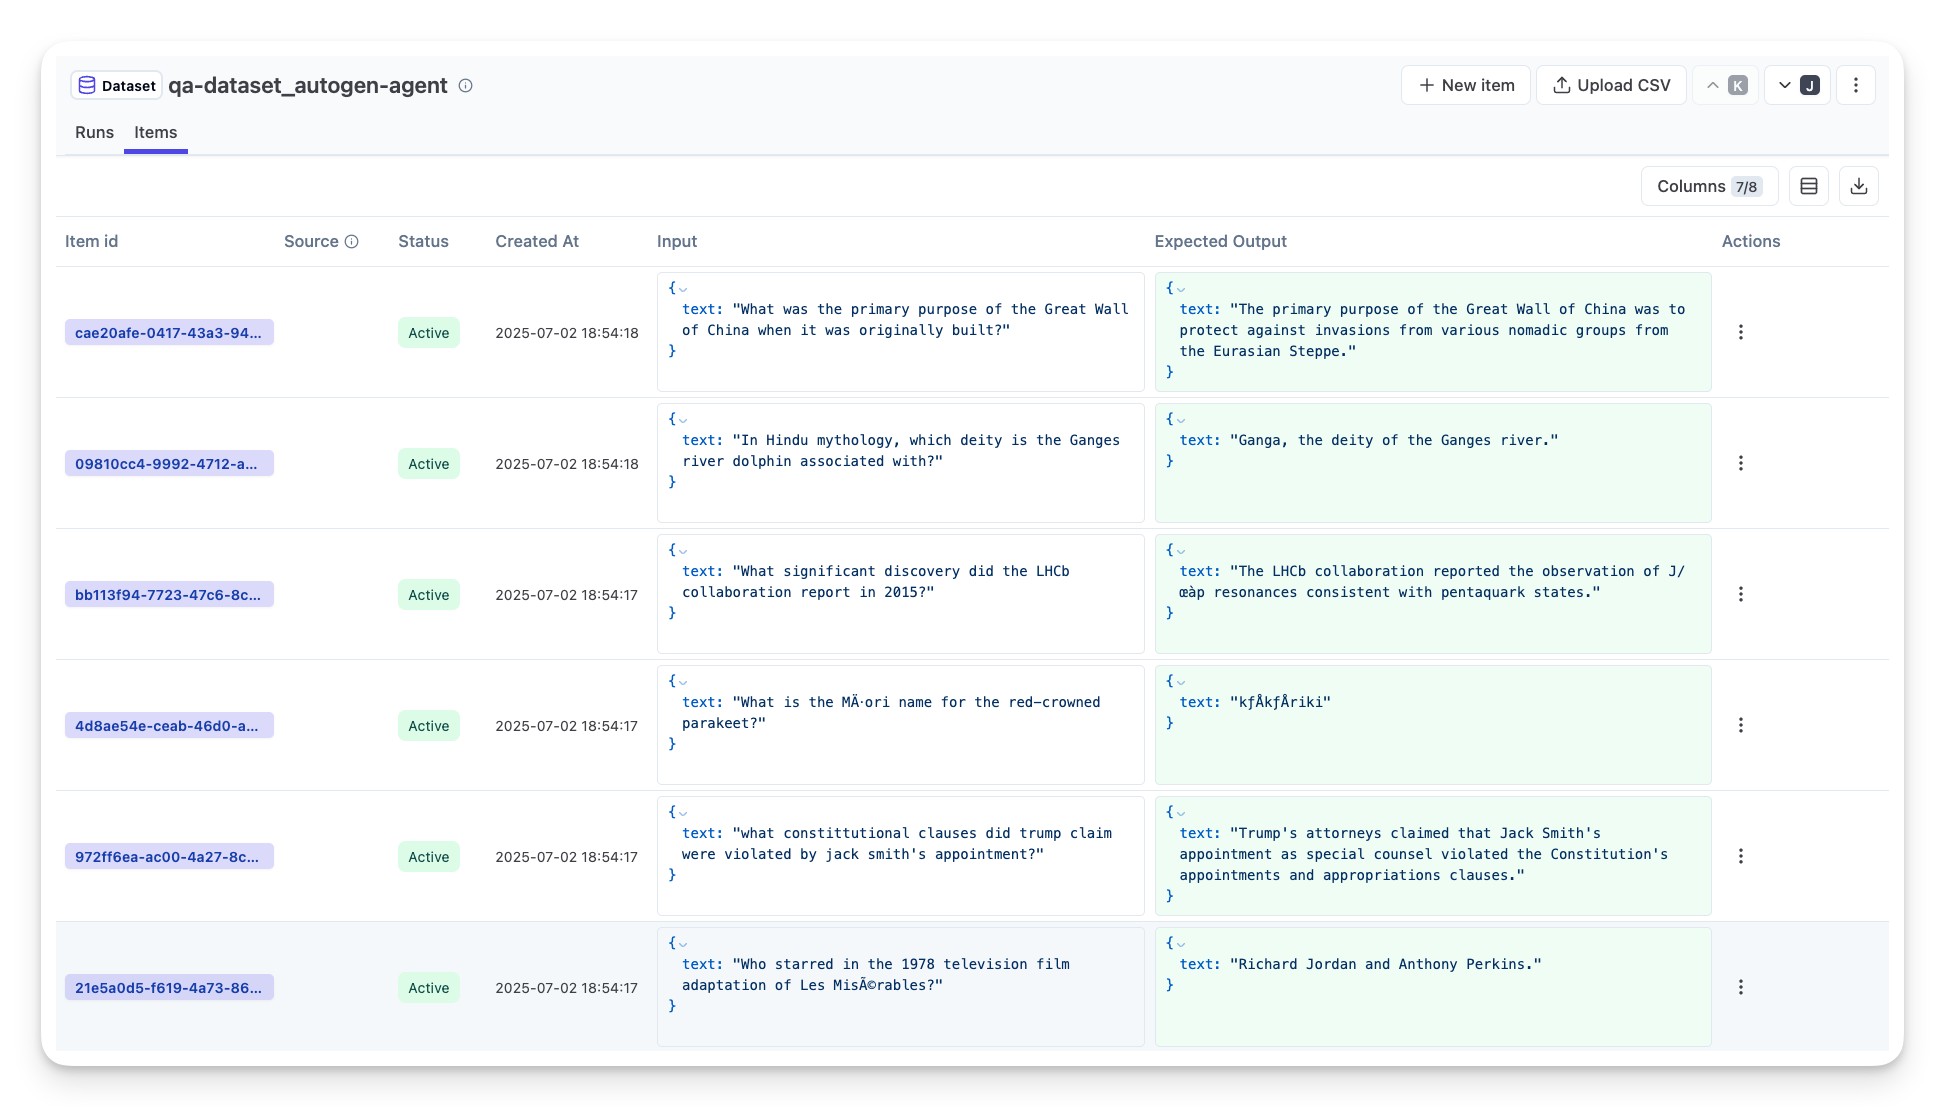
Cách này đánh giá agent trong một môi trường được kiểm soát, thường dùng bộ dữ liệu kiểm thử chứ không phải câu hỏi thật của người dùng. Bạn dùng các bộ dữ liệu được chọn lọc mà bạn biết đầu ra mong đợi hay hành vi đúng là gì, rồi chạy agent trên đó.
Ví dụ, nếu xây một agent giải toán đố, bạn có thể có một bộ dữ liệu kiểm thử 100 bài với đáp án đã biết. Đánh giá offline thường được làm trong quá trình phát triển (và có thể là một phần của pipeline CI/CD) để kiểm tra cải tiến hoặc chống thoái lui. Lợi ích là nó lặp lại được và bạn có chỉ số độ chính xác rõ ràng vì có đáp án chuẩn (ground truth). Bạn cũng có thể mô phỏng câu hỏi của người dùng và đo câu trả lời của agent so với câu trả lời lý tưởng, hoặc dùng các chỉ số tự động như mô tả ở trên.
Thách thức chính của đánh giá offline là đảm bảo bộ dữ liệu kiểm thử đầy đủ và luôn phù hợp: agent có thể làm tốt trên một bộ kiểm thử cố định nhưng gặp các câu hỏi rất khác trên production. Vì vậy, bạn nên cập nhật bộ kiểm thử với các trường hợp biên mới và ví dụ phản ánh kịch bản thực tế. Kết hợp các ca "smoke test" nhỏ với các bộ đánh giá lớn hơn là hữu ích: bộ nhỏ để kiểm tra nhanh, bộ lớn cho chỉ số hiệu năng rộng hơn.
Đánh giá online
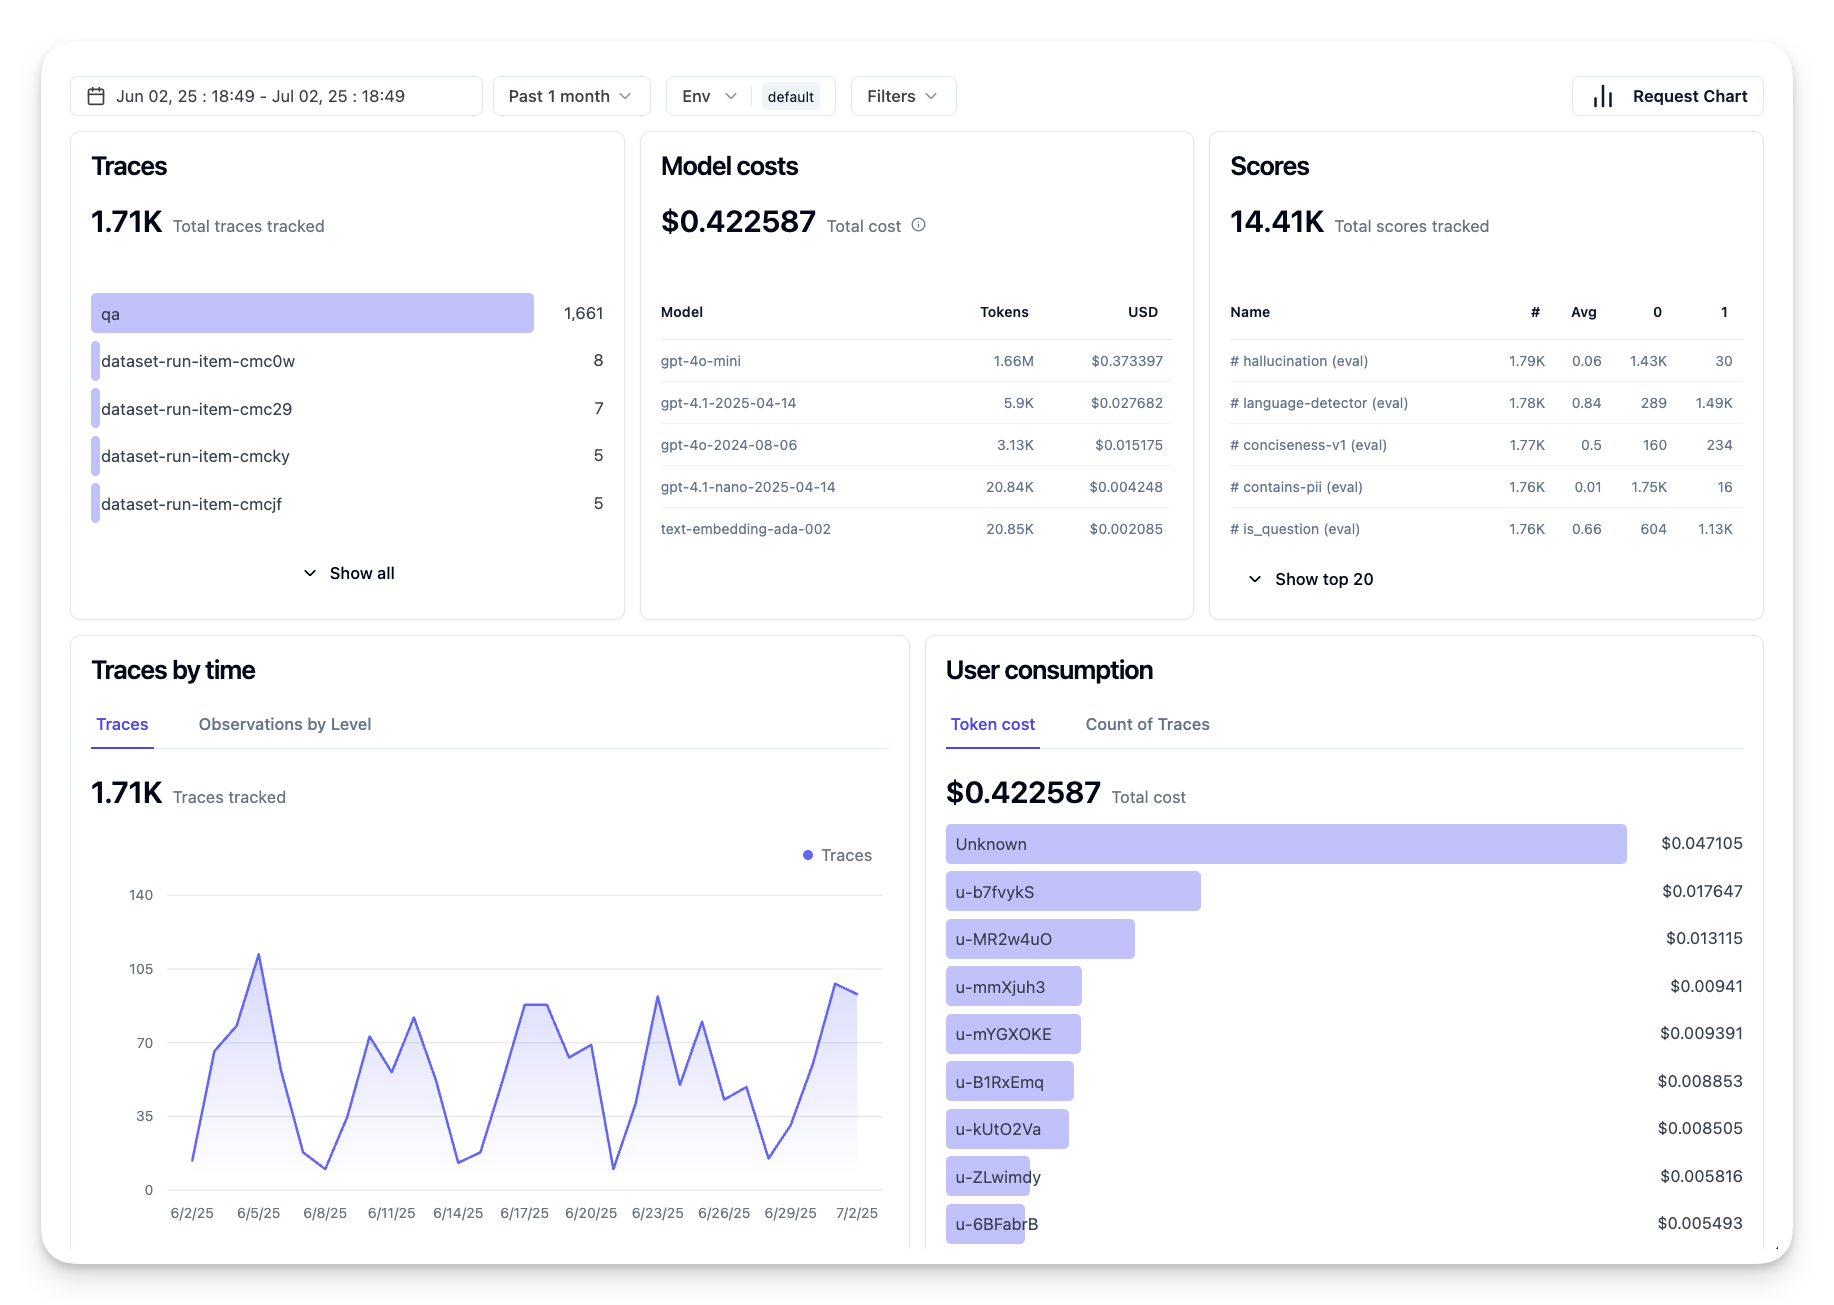
Đây là đánh giá agent trong môi trường thực tế đang chạy, tức trong lúc sử dụng thật trên production. Đánh giá online gồm việc giám sát hiệu năng agent trên các tương tác thật của người dùng và phân tích kết quả liên tục.
Ví dụ, bạn có thể theo dõi tỷ lệ thành công, điểm hài lòng của người dùng hoặc các chỉ số khác trên lưu lượng thật. Ưu điểm của đánh giá online là nó bắt được những điều bạn có thể không lường trước trong phòng thí nghiệm: bạn có thể quan sát hiện tượng trôi model theo thời gian (nếu hiệu quả của agent giảm khi mẫu đầu vào thay đổi) và phát hiện các câu hỏi hay tình huống bất ngờ không có trong dữ liệu kiểm thử. Nó cho bức tranh thật về cách agent hành xử ngoài đời.
Đánh giá online thường gồm thu thập phản hồi ngầm và tường minh của người dùng như đã nói, và có thể chạy shadow test hoặc A/B test (một phiên bản agent mới chạy song song để so sánh với bản cũ). Thách thức là khó có được nhãn hay điểm đáng tin cậy cho các tương tác thật; bạn có thể phải dựa vào phản hồi người dùng hoặc các chỉ số phía sau (như người dùng có bấm vào kết quả không).
Kết hợp cả hai
Đánh giá online và offline không loại trừ nhau; chúng bổ trợ mạnh cho nhau. Hiểu biết từ giám sát online (ví dụ các loại câu hỏi mới mà agent làm kém) có thể dùng để bổ sung và cải thiện bộ dữ liệu kiểm thử offline. Ngược lại, agent làm tốt trong kiểm thử offline có thể được triển khai và giám sát online một cách tự tin hơn.
Thực tế, nhiều nhóm áp dụng vòng lặp:
đánh giá offline -> triển khai -> giám sát online -> thu thập ca thất bại mới -> thêm vào dataset offline -> tinh chỉnh agent -> lặp lại.
Sự cố thường gặp
Khi triển khai AI agent lên production, bạn có thể gặp nhiều thách thức. Đây là một số sự cố thường gặp và giải pháp khả dĩ:
AI agent làm tác vụ không nhất quán
- Tinh chỉnh prompt giao cho AI agent; nêu rõ mục tiêu.
- Xác định chỗ nào chia tác vụ thành tác vụ con và giao cho nhiều agent xử lý sẽ có ích.
AI agent rơi vào vòng lặp liên tục
- Đảm bảo có điều khoản và điều kiện kết thúc rõ ràng để agent biết khi nào dừng.
- Với tác vụ phức tạp cần suy luận và lập kế hoạch, dùng model lớn hơn chuyên cho tác vụ suy luận.
Lời gọi tool của AI agent hoạt động kém
- Kiểm thử và xác nhận đầu ra của tool bên ngoài hệ thống agent.
- Tinh chỉnh tham số, prompt và cách đặt tên tool.
Hệ đa agent hoạt động không nhất quán
- Tinh chỉnh prompt giao cho từng agent để chúng cụ thể và khác biệt với nhau.
- Xây hệ thống phân cấp dùng một agent "định tuyến" hoặc agent điều khiển để xác định agent nào là đúng.
Nhiều sự cố trong số này có thể được phát hiện hiệu quả hơn khi đã có khả năng quan sát. Trace và chỉ số đã bàn ở trên giúp xác định chính xác vấn đề xảy ra ở đâu trong quy trình của agent, khiến việc gỡ lỗi và tối ưu hiệu quả hơn nhiều.
Quản lý chi phí
Đây là một số chiến lược quản lý chi phí khi triển khai AI agent lên production:
Dùng model nhỏ hơn: Small Language Model (SLM) có thể làm tốt một số trường hợp sử dụng agentic và giảm chi phí đáng kể. Như đã nói, xây hệ thống đánh giá để xác định và so sánh hiệu năng với model lớn hơn là cách tốt nhất để hiểu SLM sẽ làm tốt đến đâu cho trường hợp của bạn. Hãy cân nhắc dùng SLM cho các tác vụ đơn giản như phân loại ý định hay trích xuất tham số, và dành model lớn cho suy luận phức tạp.
Dùng router model: một chiến lược tương tự là dùng nhiều model với kích cỡ khác nhau. Bạn có thể dùng một LLM/SLM hoặc hàm serverless để định tuyến yêu cầu theo độ phức tạp tới model phù hợp nhất. Cách này cũng giúp giảm chi phí mà vẫn đảm bảo hiệu năng cho đúng tác vụ. Ví dụ, định tuyến câu hỏi đơn giản tới model nhỏ, nhanh hơn, và chỉ dùng model lớn đắt tiền cho tác vụ suy luận phức tạp.
Cache phản hồi: xác định các yêu cầu và tác vụ phổ biến và trả phản hồi trước khi chúng đi qua hệ thống agentic là cách tốt để giảm số yêu cầu tương tự. Bạn thậm chí có thể cài đặt một luồng xác định mức độ giống nhau giữa một yêu cầu và các yêu cầu đã cache bằng các model AI cơ bản hơn. Chiến lược này có thể giảm chi phí đáng kể cho các câu hỏi thường gặp hoặc quy trình phổ biến.
Xem cách hoạt động trong thực tế
Trong notebook ví dụ của phần này, chúng ta sẽ thấy các ví dụ dùng tool quan sát để giám sát và đánh giá agent.
Còn câu hỏi về AI agent trong production?
Tham gia Microsoft Foundry Discord để gặp gỡ những người cùng học, dự các buổi office hours và được giải đáp thắc mắc về AI agent.
Nguồn
- Dịch và biên tập từ microsoft/ai-agents-for-beginners · 10-ai-agents-production/README.md, giấy phép MIT.